У світі, де бізнес-підприємства борються один з одним за те, щоб першими змінити свою бізнес-практику, застосовуючи рішення штучного інтелекту, маркування даних, здається, є єдиним завданням, від якого всі починають спотикатися. Можливо, це тому, що якість даних, на яких ви навчаєте свої моделі ШІ, визначає їх точність і успіх.
Маркування даних або анотація даних ніколи не є одноразовою подією. Це безперервний процес. Немає ключового моменту, коли ви могли б подумати, що пройшли достатньо навчання або що ваші моделі штучного інтелекту точні для досягнення результатів.
Але де помиляється обіцянка штучного інтелекту щодо використання нових можливостей? Іноді під час процесу маркування даних.
Однією з головних проблемних точок компаній, які використовують рішення ШІ, є анотація даних. Тож давайте розглянемо 5 найпоширеніших помилок у маркуванні даних, яких слід уникати.
5 головних помилок у маркуванні даних, яких слід уникати
Не збирається достатньо даних для проекту
Дані важливі, але вони мають відповідати цілям вашого проекту. Щоб модель видавала точні результати, дані, на яких вона навчається, мають бути позначені, якість перевірена для забезпечення точності.
Якщо ви хочете розробити робоче, надійне рішення штучного інтелекту, ви повинні надати йому велику кількість високоякісних, відповідних даних. І ви повинні постійно передавати ці дані вашим моделям машинного навчання, щоб вони могли зрозуміти та співвіднести різні частини інформації, яку ви надаєте.
Очевидно, що чим більший набір даних ви використовуєте, тим кращими будуть прогнози.
Однією з підводних каменів у процесі маркування даних є збір дуже мало даних для менш поширених змінних. Коли ви позначаєте зображення на основі однієї загальнодоступної змінної в необроблених документах, ви не тренуєте свою модель ШІ глибокого навчання на інших менш поширених змінних.
Моделі глибокого навчання потребують тисяч фрагментів даних, щоб модель працювала достатньо добре. Наприклад, під час навчання роботизованої руки на основі штучного інтелекту маневрувати складною технікою кожна незначна зміна в роботі може вимагати ще однієї партії набору навчальних даних. Але збір таких даних може бути дорогим, а іноді й зовсім неможливим, і для будь-якої компанії важко зробити анотації.
Якість даних не перевіряється
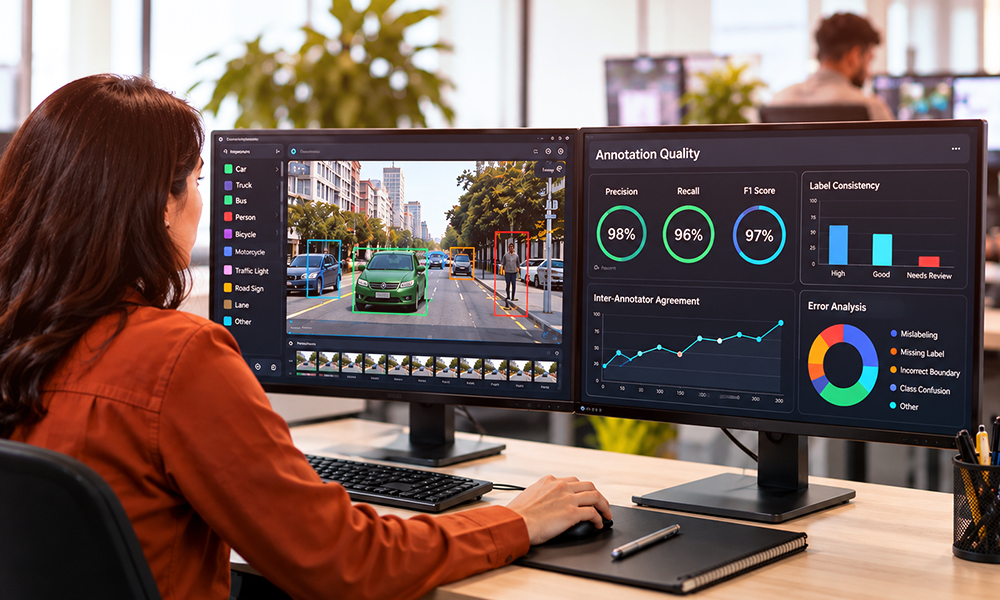
Хоча наявність даних — це одне, життєво важливо перевірити набори даних, які ви використовуєте, щоб переконатися, що вони мають високу якість. Однак підприємствам важко отримати якісні набори даних. Загалом існує два основних типи наборів даних – суб’єктивні та об’єктивні.

Проблема, пов’язана з об’єктивними даними, полягає в тому, що власник етикетки не матиме достатнього досвіду чи знань, щоб визначити правильні відповіді. Повністю позбутися людських помилок неможливо, тому життєво важливо мати стандарти та метод зворотного зв’язку із замкнутим циклом.

Не зосереджуючись на управлінні робочою силою
Моделі машинного навчання залежать від великих наборів даних різних типів, тому враховується кожен сценарій. Однак успішна анотація зображень пов’язана з власним набором проблем управління робочою силою.
Однією з основних проблем є керування великою робочою силою, яка може вручну обробляти значні неструктуровані набори даних. Наступне — підтримання високих стандартів якості всієї робочої сили. Багато проблем можуть виникнути під час проектів анотації даних.
Деякі з них:
- Необхідність навчити нових етикетників використанню інструментів анотації
- Документальне оформлення інструкцій у книзі кодів
- Переконайтеся, що всі члени команди дотримуються книги кодів
- Визначення робочого процесу – розподіл тих, хто що робить на основі їхніх можливостей
- Взаємоперевірка та вирішення технічних питань
- Забезпечення якості та перевірки наборів даних
- Забезпечення безперебійної співпраці між командами етикетувальників
- Мінімізація упередженості етикетувальника
Щоб переконатися, що ви впораєтеся з цим викликом, ви повинні покращити свої навички та можливості управління робочою силою.
Вибір невідповідних інструментів маркування даних
Обсяг ринку інструментів для анотації даних у 2020 році перевищив 1 мільярд доларів , і очікується, що до 2027 року цей показник зростатиме зі середньорічним темпом зростання понад 30%. Надзвичайне зростання інструментів для маркування даних полягає в тому, що вони трансформують результати штучного інтелекту та машинного навчання.
Використовувані методи інструментів відрізняються від одного набору даних до іншого. Ми помітили, що більшість організацій починають процес глибокого навчання, зосереджуючись на розробці власних інструментів маркування. Але дуже скоро вони розуміють, що оскільки потреби в анотаціях починають зростати, їхні інструменти не встигають. Крім того, розробка власних інструментів дорога, трудомістка і практично непотрібна.
Замість консервативного маркування вручну чи інвестування в розробку спеціальних інструментів маркування, придбання пристроїв у третьої сторони є розумним. За допомогою цього методу все, що вам потрібно зробити, це вибрати правильний інструмент на основі ваших потреб, наданих послуг і масштабованості.
Недотримання правил безпеки даних
Дотримання вимог безпеки даних незабаром значно зросте, оскільки все більше компаній збирають великі набори неструктурованих даних. CCPA , DPA та GDPR – це деякі з міжнародних стандартів дотримання вимог безпеки даних, що використовуються підприємствами.
Відповідність вимогам безпеки стає центральною проблемною точкою, коли справа доходить до аутсорсингу завдань маркування стороннім постачальникам. Безпека даних ускладнює проект, і постачальники послуг маркування повинні дотримуватися правил бізнесу.

Отже, ваш наступний великий проект ШІ чекає на правильну службу маркування даних?
Ми вважаємо, що успіх будь-якого проєкту штучного інтелекту залежить від наборів даних, які ми передаємо алгоритму машинного навчання. І якщо очікується, що проєкт штучного інтелекту видасть точні результати та прогнози, анотація та маркування даних мають першорядне значення. Передаючи ваші завдання з анотації даних на аутсорсинг , ми гарантуємо вам, що ви зможете ефективно вирішити ці проблеми.
Завдяки нашій зосередженості на постійному підтримці високоякісних наборів даних, пропонуванні замкнутого зворотного зв’язку та ефективному управлінні робочою силою ви зможете створювати першокласні проекти ШІ з вищим рівнем точності.
[Читайте також: Анотація даних власними силами чи на аутсорсингу – що дає кращі результати ШІ? ]