У нашому цифровому світі підприємства щодня обробляють тонни даних. Дані забезпечують роботу організації та допомагають їй приймати більш обґрунтовані рішення. Компанії переповнені документами: від співробітників, які створюють нові, до документів, які надходять в організацію з різних джерел, таких як електронні листи, портали, рахунки-фактури, квитанції, заявки, пропозиції, претензії тощо.
Якщо хтось не перегляне ці документи, неможливо дізнатися, про що йдеться в конкретному документі, чи найкращий спосіб його обробки. Однак вручну обробити кожен документ, щоб знати, де і як його слід зберігати, важко.
Давайте дослідимо класифікацію документів, зрозуміємо, чому класифікація документів має вирішальне значення для бізнесу, і вивчимо, як комп’ютерний зір, обробка природної мови та оптичне розпізнавання символів відіграють роль у класифікації та обробці документів.
Що таке класифікація документів?
Завдання класифікації документів вручну можуть бути великим вузьким місцем для багатьох компаній, оскільки вони займають багато часу, схильні до помилок і ресурсів. Коли використовуються моделі автоматичної класифікації на основі NLP і ML, текст у документі ідентифікується, позначається тегами та класифікується автоматично.
Завдання класифікації документів зазвичай базуються на двох класифікаціях: текстовій та візуальній. Класифікація тексту базується на жанрі, темі або типі контенту. Обробка природної мови використовується для розуміння концепції, емоцій та контексту тексту. Класифікація документів також працює разом із пов'язаними методами NLP, такими як розпізнавання іменованих сутностей , яке виявляє людей, організації та дати, що робить сортування точнішим.
Чому підприємствам потрібна класифікація документів?
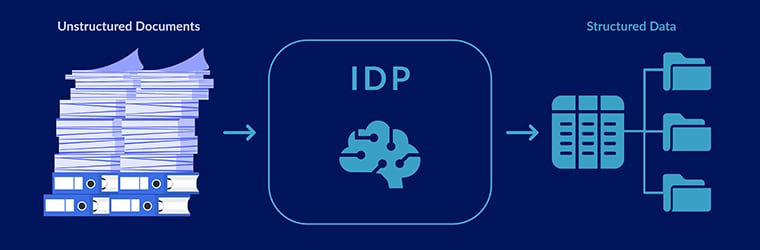
Кожна організація, від стартапів до компаній зі списку Fortune 500, щодня має справу з величезними обсягами документів. Без автоматизації ручна обробка документів стає вузьким місцем, яке уповільнює робочі процеси та виснажує ресурси.
Ось чому класифікація документів на основі штучного інтелекту є обов'язковою:
- Прискорює управління документами: автоматизує сортування, індексування та маршрутизацію, забезпечуючи миттєвий доступ до відповідних документів.
- Підвищує точність та зменшує кількість помилок: Мінімізує людські помилки, поширені в повторюваних завданнях, забезпечуючи цілісність даних.
- Підвищує операційну ефективність: Звільняє співробітників від буденних завдань, дозволяючи зосередитися на стратегічних ініціативах.
- Безперешкодне масштабування: обробляє зростаючі обсяги документів без пропорційного збільшення штату.
- Підтримує відповідність вимогам та безпеку: забезпечує правильну ідентифікацію та обробку конфіденційних документів відповідно до правил.
Такі галузі, як охорона здоров'я, фінанси, страхування, юриспруденція та електронна комерція, вже використовують класифікацію на основі штучного інтелекту для оптимізації обробки претензій, управління контрактами, підтримки клієнтів та категоризації запасів.
Класифікація документів проти класифікації текстів: розуміння нюансів
Хоча класифікація документів та класифікація текстів часто використовуються як взаємозамінні, вони мають тонкі, але важливі відмінності:
| Аспект | Класифікація тексту | Класифікація документів |
|---|---|---|
| Сфера | Зосереджується виключно на аналізі та категоризації тексту. | Аналізує як текстові, так і візуальні/макетні елементи. |
| Введення даних | Суто текстовий контент (речення, абзаци). | Весь документ, включаючи зображення, таблиці, форматування. |
| Використовуйте випадки | Аналіз настроїв, позначення тем, виявлення спаму. | Сортування рахунків-фактур, ідентифікація типу договору, обробка форм. |
| методи | НЛП-центричні методи, такі як аналіз настроїв, розпізнавання сутностей. | Поєднує НЛП з комп'ютерним зором та оптичним розпізнаванням символів (OCR). |
По суті, класифікація тексту є підмножиною класифікації документів, яка пропонує глибше, мультимодальне розуміння документів.
Як працює класифікація документів?
Класифікація документів може здійснюватися двома способами: ручним і автоматичним. Під час ручної класифікації користувач-людина має переглянути документи, знайти взаємозв’язки між поняттями та відповідно класифікувати. В автоматичній класифікації документів використовуються методи машинного та глибокого навчання. Давайте розгадаємо методи класифікації документів, розуміючи різні типи документів у бізнес-процесах.
Структуровані документи
Документ містить добре відформатовані дані з узгодженою нумерацією та шрифтами. Макет документа також узгоджений і не має відхилень. Створення інструментів класифікації для таких структурованих документів є простим і передбачуваним.
Неструктуровані документи
Неструктурований документ має вміст, представлений у неструктурованому або відкритому форматі. Приклади включають листи, контракти та накази. Оскільки вони суперечливі, стає складно знайти важливу інформацію. 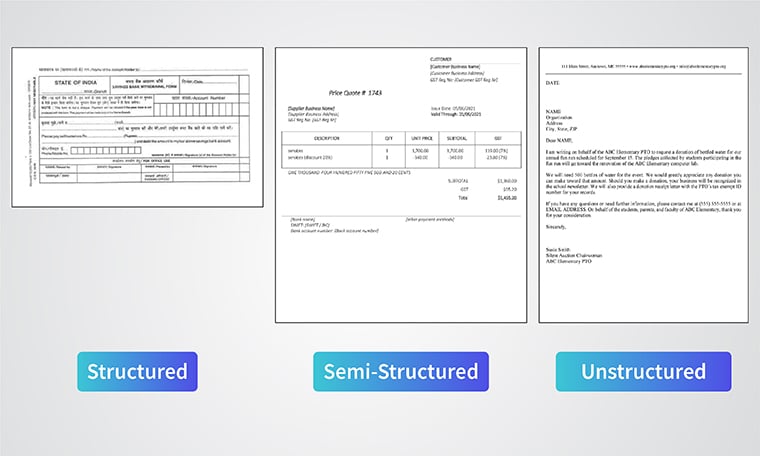
Методи класифікації документів?
Автоматична класифікація документів використовує технології машинного навчання та обробки природної мови для спрощення, автоматизації та прискорення процесу категоризації. Машинне навчання робить класифікацію документів менш громіздкою, швидшою, точнішою, масштабованою та неупередженою.
Класифікацію документів можна здійснити за допомогою трьох методів. Вони є
Техніка, заснована на правилах
Техніка, заснована на правилах, базується на лінгвістичних шаблонах і правилах, які надають інструкції моделі. Моделі навчені ідентифікувати мовні шаблони, морфологію, синтаксис, семантику тощо для позначення тексту. Цю техніку можна постійно вдосконалювати, додавати нові правила та імпровізувати для отримання точної інформації. Однак ця техніка може бути трудомісткою, нерозширюваною та складною.
Навчання під наглядом
У контрольованому навчанні визначається набір тегів, а кілька текстів додаються вручну, щоб система машинного навчання могла навчитися робити точні прогнози. Алгоритм вручну навчається на наборі документів з тегами. Чим більше даних ви подасте в систему, тим кращий результат. Наприклад, якщо в тексті зазначено: «Послуга була доступною», тег має бути під «ціною». Після завершення навчання моделі вона може автоматично передбачати непереглянуті документи.
Навчання без нагляду
У неконтрольованому навчанні схожі документи групуються в різні кластери. Це навчання не потребує будь-яких попередніх знань. Документи класифіковано на основі шрифтів, тем, шаблонів тощо. Якщо правила заздалегідь визначені, налаштовані та вдосконалені, ця модель може забезпечувати класифікацію з точністю.
Як працює класифікація документів на основі штучного інтелекту?
Класифікація документів на основі штучного інтелекту зазвичай виконує такі ключові кроки:
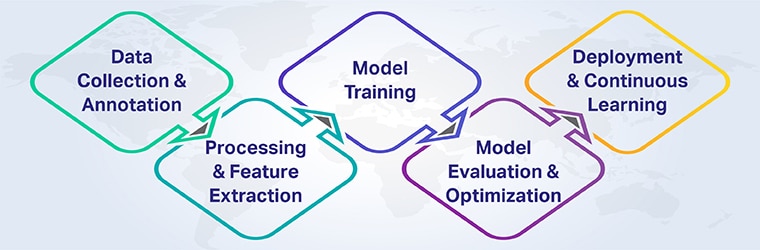
1. Збір даних і анотація
Високоякісні, різноманітні набори даних є основоположними. Документи мають бути зібрані за категоріями та точно позначені (теговані) для ефективного навчання моделей машинного навчання.
2. Попередня обробка та вилучення ознак
За допомогою оптичного розпізнавання символів (OCR) текст витягується зі сканованих або зображених документів — точність тут залежить від надійних моделей машинного навчання OCR, навчених на різноманітних даних документа. Потім методи NLP очищують, токенізують та перетворюють текст на значущі елементи. Одночасно комп'ютерний зір аналізує макети документів та візуальні підказки.
3. Модельне навчання
Алгоритми навчання з учителем (наприклад, трансформатори, CNN) навчаються на позначених даних для розпізнавання закономірностей. Моделі вчаться пов'язувати характеристики документів з категоріями.
4. Оцінка та оптимізація моделі
Моделі ретельно тестуються на невидимих даних для вимірювання точності, прецизійності та повноти. Гіперпараметри налаштовуються для покращення продуктивності.
5. Розгортання та безперервне навчання
Після розгортання моделі класифікують вхідні документи в режимі реального часу та вдосконалюються з часом завдяки циклам зворотного зв'язку та додатковим навчальним даним.
Реальні випадки використання
Класифікація документів використовується для вирішення кількох бізнес-проблем. Хоча більшість випадків використання не є завданнями класифікації, алгоритм використовується для вирішення кількох реальних проблем.
Виявлення спаму
Класифікація документів, зокрема класифікація тексту, використовується для виявлення небажаного спаму. Модель навчена виявляти фрази спаму та їх частоту, щоб визначити, чи є повідомлення спамом. Наприклад, детектор спаму в Gmail від Google використовує техніку обробки природної мови, щоб виявляти слова, які часто зустрічаються в небажаних повідомленнях, і скидати пошту в правильну папку.
Аналіз почуттів
Аналіз настроїв за допомогою соціального прослуховування допомагає компаніям зрозуміти своїх клієнтів, їхні думки та відгуки. Класифікуючи відгуки, відгуки та скарги та класифікуючи їх на основі їхньої емоційної природи, моделі на основі НЛП допомагають аналізувати настрої. Модель навчена виділяти слова, які позначають або мають позитивні чи негативні конотації.
Класифікація квитка або пріоритету
Відділ обслуговування клієнтів будь-якого підприємства стикається з багатьма запитами на обслуговування та квитками. Автоматизований інструмент класифікації документів може допомогти пробратися через величезну кількість квитків. Використовуючи NLP, пріоритетні квитки можна направити до потрібного відділу. Це значно покращує швидкість вирішення, обробки та обслуговування.
Розпізнавання об'єктів
Автоматизована класифікація документів також використовується для обробки великих обсягів візуальних даних у документах шляхом їх класифікації за категоріями. Розпізнавання об’єктів зазвичай використовується в електронній комерції або на виробничих підрозділах для класифікації продуктів.
Початок роботи з класифікацією документів на основі AI
Документи містять дані, важливі для функціонування бізнесу. Документи містять цінну інформацію, яка сприяє розвитку операцій, послуг і цілей розвитку організації.
Однак класифікація документів — справа нудна, але необхідна. Оскільки класифікація документів є проблемою, особливо якщо їх обсяг відносно великий, необхідно мати автоматизовану систему класифікації документів.
Модель класифікації документів на основі штучного інтелекту, навчена алгоритмами машинного навчання, є ефективною, економічною, безпомилковою та точною. Але процес може розпочатися лише тоді, коли модель, яку ви створюєте, навчена на якісних і точно позначених наборах даних.
Shaip пропонує вам попередньо позначені набори даних , які допомагають у розробці точних моделей класифікації. Зв’яжіться з нами та почніть роботу з інструментом класифікації документів просто зараз.