Навчання з підкріпленням (НП) чудово допомагає навчитися, що робити, коли сигнал винагороди чистий, а середовище прощає. Але багато реальних ситуацій не такі. Вони безладні, з високими ставками та сповнені «майже правильних» рішень. Саме тут перевірені експертами набори даних про міркування стають множником сили: вони навчають моделі причині дії , а не лише її результату.
Приховане вузьке місце в продуктивності RL: слабкі сигнали міркування
RL-агенти можуть виглядати вражаюче під час навчання, але все одно зазнавати невдачі під час розгортання. Одна з поширених причин полягає в тому, що модель вивчає скорочені шляхи — шаблони, які приносять винагороду у знайомих сценаріях, але руйнуються, коли умови змінюються.
Ось невелика історія, яку ви впізнаєте, якщо постачали системи RL:
Команда складських роботів навчає агента збирати та розміщувати предмети. У симуляції показники успіху швидко зростають. Але на реальних поверхах робот починає «імітувати» налаштування — вибираючи ризиковані траєкторії, які працюють у симуляторі, але призводять до зіткнень поблизу відбиваючих поверхонь. Функція винагороди не була помилковою. Міркування, яке засвоїла модель, було неповним.
Коли ваші дані фіксують лише результати («успіх/невдача» або скалярну винагороду), ви не враховуєте логіку проміжних рішень, яку люди використовують інстинктивно: обмеження, перевірки безпеки та порядок кроків.
Що насправді включають «дані міркувань, перевірені експертами»
На практичному рівні, перевірені експертами дані міркувань – це кураторський набір прикладів, де фахівці в предметній області перевіряють шлях прийняття рішень, а не лише кінцевий результат.
Сліди міркувань: відсутня середина
Слід міркування — це покроковий маршрут від спостереження → рішення → дія. Залежно від вашого випадку використання, це може виглядати так:
- виявлення відповідних сигналів («виявлено дрейф датчика; знижено достовірність»)
- застосування правил домену («поступіться перед в'їздом; надайте пріоритет пішоходам»)
- вибір дій з обмеженнями («виберіть шлях B, щоб уникнути сліпої зони»)
Що означає «перевірено» (простою мовою)
«Перевірено» зазвичай включає:
- рекомендації, розроблені експертами або рецензовані експертами
- узгоджене маркування рубрик (щоб два експерти вирішували один і той самий випадок однаково)
- систематичні перевірки на наявність суперечностей та пропущених кроків
- журнал аудиту змін у міру розвитку інструкцій
Це важливо, оскільки невеликі логічні помилки можуть накопичуватися каскадом, особливо коли ви пізніше навчаєте моделі винагород або використовуєте петлі зворотного зв'язку з людьми.
Як набори даних міркувань покращують продуктивність моделі навчання з підкріпленням
Переваги не містичні. Вони механічні.
Швидша конвергенція, менше винагород за хакерство
Сліди міркувань зменшують простір пошуку. Замість сліпого дослідження, агент отримує структуровані сигнали про те, які проміжні кроки є допустимими. Зазвичай це означає менше ітерацій навчання, витрачених на глухі кути, та менше «розумних» застосувань функції винагороди.
Дослідження RLHF та моделювання винагород неодноразово підкреслюють, наскільки чутливим може бути навчання до шумних або низькоякісних даних про уподобання/зворотний зв'язок (Джерело: Асоціація обчислювальної лінгвістики, 2024). Ця чутливість не зникає в RL — вона посилюється.
Краще узагальнення на граничні випадки
Експертні міркування кодують обмеження та принципи , які переносяться: межі безпеки, правила відповідності та причинно-наслідкова логіка. Коли середовище змінюється, ці принципи залишаються актуальними, навіть якщо ті самі пікселі, текст чи переходи станів не змінюються.
Стабільніше моделювання винагород та цикли RLHF
Якщо ви використовуєте методи пост-навчання у стилі RLHF, дані міркувань допомагають вам створювати кращі моделі винагород, оскільки модель винагороди може навчитися оцінювати не лише «правильні відповіді», але й «правильні шляхи прийняття рішень». Це призводить до більш послідовних оновлень під час оптимізації та меншої кількості регресій під час масштабування навчання.
Якщо ви будуєте або масштабуєте трубопроводи RLHF, рішення Shaip для RLHF розроблені на основі робочих процесів під керівництвом експертів та контролю якості, що підтримують узгоджені дані вирівнювання.
Аналогія: години нальоту проти льотної інструкції
Уявіть собі навчання з льотного навчання (RL) як навчання пілотів. Ви можете налітати нескінченну кількість годин лише на симуляторі, але якщо ви практикуватимете неправильні звички, ви їх закріпите. Інструктор не просто каже «зараховано/не зараховано». Він виправляє ваші міркування під час польоту: порядок сканування, час прийняття рішень та управління ризиками. Перевірені експертами набори даних міркувань відіграють цю роль «інструктора» для RL — навчаючи модель продумувати завдання, а не лише те, чи приземлилося воно.
Порівняльна таблиця: моделі внутрішньої перевірки, краудсорсингу та аутсорсингу
Більшість команд зрештою мають гібридну структуру, але корисно чітко розуміти компроміси.
Для ширших потреб маркування, що підключаються до конвеєрів RL та RLHF, послуги анотації даних Shaip можуть підтримувати все: від розробки рекомендацій до багатоетапного контролю якості, особливо коли вам потрібна повторювана якість у великих масштабах.
Практичний посібник з контролю якості для перевірених експертами наборів даних для міркувань
Ось посібник, який відображає те, що використовують високопродуктивні команди.
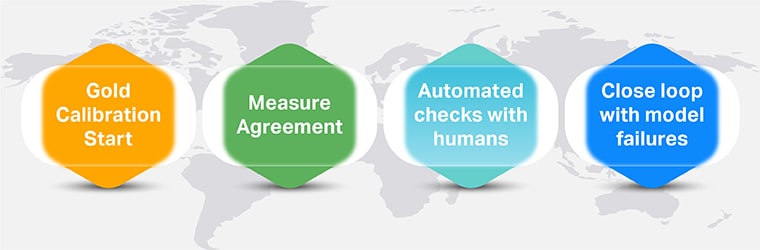
1. Почніть із «золота» та калібрування
Створіть золотий набір канонічних прикладів (включаючи складні крайні випадки). Використовуйте його для калібрування анотаторів та узгодження експертів щодо того, як виглядає «гарне міркування».
2. Вимірюйте згоду, а потім правильно вирішуйте розбіжності
Використовуйте узгодження між анотаторами, де це має сенс (і уникайте нав'язування згоди у випадках, що за своєю суттю неоднозначні). Ключовим є арбітраж : розбіжності повинні призводити до кращих рекомендацій, а не просто до підкидання монети.
3. Додайте автоматизовані перевірки, але залиште відповідальність за людей
Автоматизуйте перевірку того, що дешево:
- узгодженість формату (кількість кроків, валідність схеми)
- порушення правил (відсутність обмежень, заборонені дії)
- виявлення суперечності (крок говорить «А», потім має на увазі «не А»)
Потім направляйте позначені елементи на експертну перевірку. Саме тут гібридний контроль якості людини та штучного інтелекту виправдовує себе: машини виявляють «очевидні помилки», а експерти виправляють «незначні помилки».
4. Замкніть цикл з помилками моделі
Розглядайте помилки розгортання як зворотний зв'язок щодо набору даних. Коли модель не працює, запитайте:
- Чи трасування міркувань не мало обмеження?
- Чи недостатньо чітко визначено в інструкціях граничний випадок?
- Чи ми переналаштувалися на логіку «щасливого шляху»?
Цей цикл перетворює ваш набір даних на живий актив, а не на одноразовий продукт. Для команд, які будують канали обробки даних від початку до кінця (збір → контроль якості → доставка), сервіси даних для навчання штучному інтелекту від Shaip можуть допомогти впроваджувати це безперервно.
Структура рішень: як обрати правильну стратегію перевірки
Скористайтеся цими шістьма питаннями, щоб вибрати правильне поєднання внутрішніх, краудсорсингових та керованих послуг: