Як і розробка програмного забезпечення, яке працює на основі коду, розробка робочих моделей штучного інтелекту та машинного навчання вимагає високоякісних даних. Моделі потребують точно позначених та анотованих даних на кількох етапах виробництва, оскільки алгоритм потрібно постійно навчати для виконання завдань.
Але якісні дані важко знайти. Іноді набори даних можуть містити помилки, які можуть вплинути на результат проекту. Експерти з обробки даних першими скажуть вам, що вони витрачають більше часу на очищення та перевірку даних, ніж на їх оцінку та аналіз.
Чому в першу чергу виникають помилки в наборі даних?
Чому важливо мати точні набори навчальних даних?
Які бувають типи помилок даних навчання ШІ ? І як їх уникнути?
Почнемо зі статистики.
Група дослідників з Лабораторії комп'ютерних наук та штучного інтелекту Массачусетського технологічного інституту ретельно дослідила десять великих наборів даних, які цитувалися понад 100 000 разів. Дослідники виявили, що середній рівень помилок становив приблизно 3.4% у всіх проаналізованих наборах даних . Також було виявлено, що набори даних містили різні типи помилок , такі як неправильне маркування зображень, аудіо та настроїв тексту.
Чому в першу чергу виникають помилки в наборі даних?

Наприклад, уявіть, що ви попросили свого офісного помічника зібрати повну інформацію про всі ваші підприємства та вручну ввести їх у електронну таблицю. У той чи інший момент станеться помилка. Адреса може бути неправильною, може виникнути дублювання або невідповідність даних.
Помилки в даних також можуть виникати, якщо їх збирають датчики через несправність обладнання, пошкодження датчика або ремонт.
Чому важливо мати точні набори навчальних даних?
Усі алгоритми машинного навчання навчаються на даних, які ви надаєте. Позначені та анотовані дані допомагають моделям знаходити зв'язки, розуміти концепції, приймати рішення та оцінювати свою ефективність. Важливо навчати вашу модель машинного навчання на безпомилкових наборах даних, не турбуючись про пов'язані з цим витрати чи час, необхідний для навчання. Як і в довгостроковій перспективі, час, який ви витрачаєте на отримання якісних даних, покращить результат ваших проектів зі штучним інтелектом.
Навчання ваших моделей на точних даних дозволить вашим моделям робити точні прогнози та підвищувати їх продуктивність . Якість, кількість та використані алгоритми визначають успіх вашого проєкту штучного інтелекту.
Які існують типи помилок даних навчання ШІ?
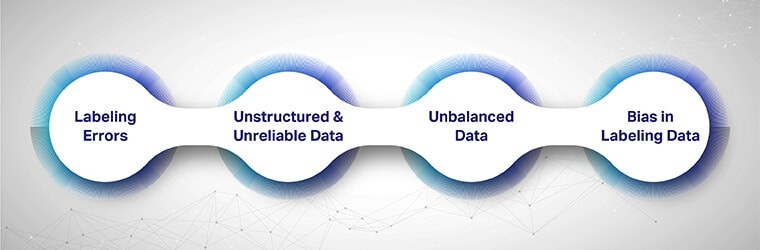
Помилки маркування, ненадійні дані, незбалансовані дані, зміщення даних
Ми розглянемо чотири найпоширеніші помилки навчальних даних і способи їх уникнення.
Помилки маркування
Помилки маркування є одними з найпоширеніших помилок, що зустрічаються в навчальних даних. Якщо тестові дані моделі містять неправильно марковані набори даних, отримане рішення не буде корисним. Спеціалісти з обробки даних не зроблять точні або змістовні висновки щодо продуктивності чи якості моделі.
Помилки в маркуванні бувають різних форм. Ми використовуємо простий приклад, щоб підкреслити думку. Якщо анотатори даних мають просте завдання намалювати обмежувальні рамки навколо кожного кота на зображеннях, імовірно, можуть виникнути такі типи помилок міток.
- Неточна посадка: надмірна підгонка моделі трапляється, коли обмежувальні рамки намальовані не так близько до об’єкта (кота), залишаючи кілька прогалин навколо наміченої речі.
- Відсутні мітки: У цьому випадку анотатор може пропустити позначку кота на зображеннях.
- Неправильне тлумачення інструкції: Інструкції, надані анотаторам, незрозумілі. Замість того, щоб розміщувати одну обмежувальну рамку навколо кожного кота на зображеннях, анотатори розміщують одну обмежувальну рамку, що охоплює всіх котів.
- Обробка оклюзії: Замість розміщення обмежувальної рамки навколо видимої частини кота, анотатор розміщує обмежувальні рамки навколо очікуваної форми частково видимого кота.
Неструктуровані та недостовірні дані
Обсяг проекту ML залежить від типу набору даних, на якому він навчається. Компанії повинні використовувати свої ресурси для отримання наборів даних, які є оновленими, надійними та репрезентативними для необхідного результату.
Коли ви навчаєте модель на неоновлених даних, це може призвести до довгострокових обмежень у програмі. Якщо ви навчаєте свої моделі на нестабільних і непридатних даних, це відображатиме корисність моделі AI.
Незбалансовані дані
Будь-який дисбаланс даних може призвести до відхилень у продуктивності вашої моделі. Під час побудови високопродуктивних або складних моделей слід ретельно розглянути склад навчальних даних. Дисбаланс даних може бути двох типів:
- Класовий дисбаланс: Класовий дисбаланс виникає, коли дані навчання має дуже незбалансований розподіл класів. Іншими словами, немає репрезентативного набору даних. Коли в наборах даних є дисбаланс класів, це може спричинити багато проблем під час побудови за допомогою реальних програм.
Наприклад, якщо алгоритм навчається розпізнаванню котів, дані навчання містять лише зображення котів на стінах. Тоді модель буде добре працювати при ідентифікації котів на стінах, але погано працюватиме за інших умов. - Останні дані: Жодна модель не є повністю сучасною. Всі моделі зазнають виродження, як Реальний світ середовище постійно трансформується. Якщо модель регулярно не оновлюватиметься відповідно до змін навколишнього середовища, її корисність і цінність, ймовірно, зменшаться.
Наприклад, донедавна поверхневий пошук за терміном «Супутник» міг отримати результати про російську ракету-носій. Однак результати пошуку після пандемії були б зовсім іншими і повними російської вакцини від Covid.
Зміщення в даних маркування
Упередженість у навчальних даних — це тема, яка час від часу виникає. Зміщення даних може бути спричинене під час процесу маркування або анотаторами. Зміщення даних може виникнути під час використання значної різнорідної групи анотаторів або коли для маркування потрібен певний контекст.
Зменшення упередженості можливе, коли завдання виконують анотатори з усього світу або анотатори з певного регіону. Якщо ви використовуєте набори даних з усього світу, існує висока ймовірність того, що анотатори припустять помилки в маркуванні.
Наприклад, якщо ви працюєте з різними кухнями з усього світу, анотатор у Великобританії може бути не знайомий із харчовими уподобаннями азіатів. Отриманий набір даних матиме упередження на користь англійської мови.
Як уникнути помилок даних навчання AI?
Найкращий спосіб уникнути помилок у навчальних даних — це запровадити суворий контроль якості на кожному етапі процесу маркування.
Ви можете уникнути помилок маркування даних , надаючи чіткі та точні інструкції анотаторам. Це може забезпечити однорідність та точність набору даних.
Щоб уникнути дисбалансу в наборах даних, отримайте найновіші, оновлені та репрезентативні набори даних. Переконайтеся, що набори даних нові та невикористані, перш ніж навчати та тестувати моделі машинного навчання.
Потужний проект штучного інтелекту процвітає на свіжих, неупереджених та надійних навчальних даних, щоб досягти найкращих результатів. Вкрай важливо впроваджувати різні перевірки та заходи якості на кожному етапі маркування та тестування. Помилки навчання можуть стати значною проблемою, якщо їх не виявити та не виправити до того, як вони вплинуть на результат проекту.
Найкращий спосіб забезпечити якісні набори даних для навчання ШІ для вашого проєкту на основі машинного навчання – це найняти різноманітну групу анотаторів, які мають необхідні знання та досвід у предметній області для проєкту.
Ви можете швидко досягти успіху з командою досвідчених анотаторів Shaip , які надають інтелектуальні послуги з маркування та анотації для різноманітних проектів на основі штучного інтелекту. Зателефонуйте нам і переконайтеся в якості та продуктивності ваших проектів зі штучним інтелектом.