У сучасному швидкоплинному, технологічно керованому світі, такі програми розмовного штучного інтелекту, як Alexa, Siri та Google Home, стали незамінними в нашому повсякденному житті. Вони спрощують завдання, надають миттєві рішення та покращують нашу взаємодію з машинами. Але за безперебійним досвідом криється лабіринт викликів, з якими стикаються розробники під час створення інтелектуальних розмовних систем.
Зі зростанням попиту на розумніших, багатомовних та емоційно інтелектуальних помічників у чаті, важливо розуміти перешкоди у створенні цих інструментів та способи їх ефективно подолати. У цьому посібнику ми розглянемо найактуальніші проблеми з даними в розмовному штучному інтелекті та запропонуємо практичні рішення для створення моделей штучного інтелекту, які дійсно знайдуть відгук у користувачів.
Найпоширеніші проблеми з даними в розмовному штучному інтелекті

1. Різноманітність мов та діалектів
Однією з найбільших проблем у розмовному штучному інтелекті є величезна різноманітність мов, якими розмовляють по всьому світу. Хоча приблизно 1.35 мільярда людей розмовляють англійською як рідною або другою мовою, це становить менше 20% населення світу. Таким чином, залишаються мільярди потенційних користувачів, які спілкуються іншими мовами, часто багатими на унікальні діалекти, сленг та культурні нюанси.
Рішення:
Щоб подолати цю розбіжність, підприємствам потрібен доступ до величезних, високоякісних багатомовних наборів даних, які охоплюють не лише основні мови, а й регіональні діалекти та розмовні мови. Використання попередньо анотованих наборів мовленнєвих даних, адаптованих для глобальних ринків, може покращити інклюзивність та універсальність моделей розмовного штучного інтелекту.
2. Захоплення динамізму мови
Мови живі — вони розвиваються з часом, містять сленг та відображають емоції. Цей динамізм створює труднощі для моделей штучного інтелекту, яким важко інтерпретувати тонкі нюанси, такі як тон, сарказм та настрої. Люди спілкуються не лише словами, і нездатність врахувати цей «людський фактор» може призвести до безособових або недоречних відповідей.
Рішення:
Навчайте свій ШІ за допомогою наборів даних, що містять реальні приклади емоційних, контекстних та культурних варіацій. Використання наборів даних для навчання емоційно інтелектуального ШІ гарантує, що ваш розмовний помічник розуміє глибший контекст запитів користувачів, що призводить до більш природних та змістовних взаємодій.
3. Фоновий шум та перешкоди
Від гавкоту собак та дверних дзвінків до дублювання розмов, звук у реальному світі рідко буває бездоганним. Ці фонові шуми часто заважають системам розпізнавання голосу, знижуючи точність розмовного штучного інтелекту. Крім того, коли в одному середовищі співіснує кілька голосових помічників, розрізнити команди користувача від конкуруючих пристроїв може бути складно.
Рішення:
Розширені алгоритми фільтрації шуму в поєднанні з високоякісними наборами аудіоданих з реального світу можуть допомогти навчити ваш штучний інтелект розпізнавати людські команди та надавати їм пріоритет над фоновим шумом. Розробка надійних моделей розпізнавання голосу , що враховують різноманітні акустичні середовища, має вирішальне значення для подолання цієї проблеми.
4. Проблеми синхронізації звуку
Під час навчання інструментів штучного інтелекту за допомогою телефонних розмов синхронізація звуку як від абонента, так і від агента може бути проблематичною. Невідповідність аудіоданих створює прогалини в розумінні перебігу розмови, що призводить до неефективності навчання моделі.
Рішення:
Інвестуйте в набори даних, які попередньо синхронізовані та анотовані для двоканального аудіо. Це гарантує, що розмови точно узгоджені та готові до навчання, зменшуючи ручну працю та покращуючи продуктивність моделі.
5. Відсутність даних, специфічних для предметної області
Розмовний ШІ не є універсальним рішенням. Хоча універсальні чат-боти добре справляються з простими завданнями, вони часто не дають точних відповідей на галузеві запити — будь то охорона здоров'я, фінанси чи автомобільна промисловість.
Рішення:
Для створення галузевих програм штучного інтелекту вам потрібні налаштовані набори даних , що відображають термінологію, процеси та очікування користувачів у цій галузі. Наприклад, навчання вашого чат-бота для охорони здоров'я за допомогою анотованих медичних розмов або наборів даних електронних медичних карток може значно підвищити його точність та релевантність.
[Читайте також: Телемедицина на базі штучного інтелекту: приклади використання, переваги та реальні виклики ]
Вплив проблем з даними на споживачів
На відміну від текстових пошукових систем, які пропонують кілька варіантів, від розмовного штучного інтелекту очікується одна точна відповідь. Коли базові набори даних упереджені або неповні, результати можуть бути оманливими, нерелевантними або навіть неприємними для користувачів. Така відсутність точності не лише знижує довіру користувачів, але й впливає на репутацію бренду.
Для бізнесу ставки очевидні: кращі дані призводять до кращого клієнтського досвіду . Вирішення цих проблем на етапах збору даних та навчання моделі гарантує, що ваш розмовний ШІ постійно надаватиме цінність своїм користувачам.
Як подолати проблеми з даними та створити розумніший штучний інтелект
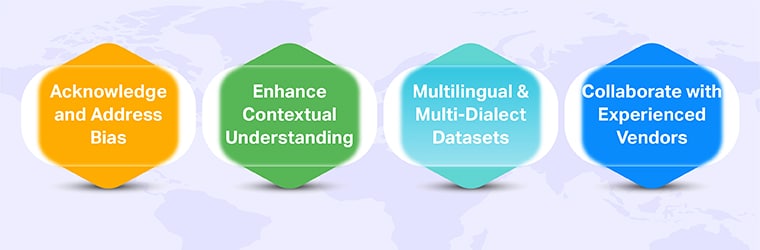
1. Визнайте та вирішіть упередження
Першим кроком до створення кращого штучного інтелекту є визнання наявності упередженості в наборах даних. Проактивне впровадження стратегій виявлення та пом'якшення упередженості, таких як цикли зворотного зв'язку з користувачами та налаштування параметрів, може допомогти запобігти спотворенню результатів.
2. Покращення контекстуального розуміння
Навчання вашої моделі розумінню контекстуальних розмов є критично важливим. Цього можна досягти, використовуючи набори даних, що відображають реальні моделі взаємодії, включаючи розмови з кількома мовцями та спонтанні діалоги.
3. Інвестуйте в багатомовні та багатодіалектні набори даних
Розширення мовного охоплення за допомогою різноманітних наборів даних є ключем до охоплення глобальної аудиторії. Співпрацюючи з постачальниками даних, які спеціалізуються на багатомовних наборах даних для навчання розмовному штучному інтелекту , компанії можуть масштабувати свої рішення зі штучного інтелекту для задоволення потреб різноманітних ринків.
4. Співпрацюйте з досвідченими постачальниками
Співпраця з досвідченим партнером для збору даних на основі штучного інтелекту за допомогою розмовної технології може значно спростити процес збору та анотації. Досвідчені постачальники мають досвід у створенні високоякісних, налаштовуваних наборів даних, адаптованих до ваших конкретних потреб. Це не лише знижує витрати, але й прискорює час виведення ваших рішень на ринок зі штучним інтелектом.
[Читайте також: Зростання популярності голосових асистентів на основі штучного інтелекту для підвищення якості охорони здоров'я ]
Тенденції, що формують майбутнє розмовного штучного інтелекту
- Біометрія голосу: Системи штучного інтелекту інтегрують голосову біометрію для підвищення безпеки та персоналізації. За допомогою біометричних наборів даних компанії можуть створювати рішення на основі штучного інтелекту, які розпізнають окремих користувачів за їхніми унікальними голосовими патернами.
- Мультимодальний ШІ: Розмовний ШІ наступного покоління поєднує текстові, голосові та візуальні дані для забезпечення більш насиченого та інтерактивного користувацького досвіду. Навчання моделей ШІ за допомогою мультимодальні набори даних стає пріоритетом для підприємств, які прагнуть залишатися на позиціях лідерів.
- Генеративний штучний інтелект для розмов: Генеративні моделі штучного інтелекту, такі як ChatGPT, революціонізують розмовні системи. точно налаштовані набори даних генеративного штучного інтелекту може надати вашому помічнику в чаті можливість генерувати відповіді, які здаються більш людяними та адаптивними.

Співпрацюйте з Shaip для отримання точних наборів даних розмовного штучного інтелекту
У Shaip ми спеціалізуємося на наданні високоякісних, індивідуально розроблених наборів даних для розмовного штучного інтелекту. Незалежно від того, чи створюєте ви багатомовного чат-бота, налаштовуєте голосового помічника чи розробляєте галузевий додаток, наш великий каталог наборів даних мовлення, аудіо та тексту може забезпечити успіх вашого проекту.
Маючи досвід у понад 65 мовах та діалектах, Шайп допомагає компаніям долати проблеми з даними та створювати інклюзивні, інтелектуальні та ефективні рішення зі штучним інтелектом. Дозвольте нам допомогти вам розкрити весь потенціал розмовного штучного інтелекту.