Мультимодальний ШІ: Повний посібник з навчальних даних, моделей та варіантів використання
Однак більшість команд недооцінюють, що насправді потрібно для створення цих даних. Вони ставляться до цього як до завдання маркування. Це не так. Це проблема координації: кілька типів даних збираються синхронно, анотуються за допомогою узгоджених схем та узгоджуються за модальнимністю, перш ніж модель побачить хоч один приклад.
У Shaip, яка зараз є частиною екосистеми Ubiquity, ми співпрацюємо з командами штучного інтелекту, які створюють набори даних для текстових, мовних, графічних, відео, сенсорних та медичних візуалізаційних методів. Закономірності, що відрізняють високопродуктивні мультимодальні моделі від дорогих невдач, зводяться до рішень щодо якості даних, прийнятих на ранніх етапах, — рішень, які цей посібник вам допоможе.
До кінця цієї статті ви зрозумієте, як навчаються мультимодальні моделі, де провідні моделі 2026 року отримують свою перевагу, які галузі впроваджують мультимодальний ШІ у великих масштабах з перевіреними результатами, і як саме отримувати дані, необхідні для його роботи.
Що таке мультимодальні дані для навчання ШІ?
Дані для навчання мультимодального ШІ – це структурована колекція парних або чергуваних вхідних даних з двох або більше модальностей даних, таких як зображення з текстовими підписами, аудіозаписи зі стенограмами або відео із синхронізованими показниками датчиків, які використовуються для навчання моделей ШІ розуміти та міркувати в цих модальностях разом. На відміну від унімодальних наборів даних, які навчають моделі на одному типі даних, мультимодальні набори даних вимагають крос-модального узгодження: кожен приклад повинен передавати узгоджене значення в усіх присутніх модальностях.
Ця відмінність має значення на практиці. Модель, що працює лише з текстом і навчається на клінічних нотатках, вчиться прогнозувати діагнози зі слів. Мультимодальна модель, навчена на клінічних нотатках та відповідних даних візуалізації, може вловлювати закономірності, які жодна з модальностей не виявляє окремо. Таке поєднання вимагає принципово іншого підходу до збору даних, анотацій та контролю якості.
Мультимодальні послуги з обробки навчальних даних Shaip охоплюють шість основних модальностей:
| Модальність | прикладів | Основні випадки використання |
|---|---|---|
| текст | Документи, стенограми, підказки | Магістр права, НЛП, штучний інтелект у документуванні |
| зображення | Фотографії, медичні скани, супутникові знімки | Комп'ютерний зір, діагностика |
| аудіо | Мова, звуки навколишнього середовища, музика | ASR, настрої, голосовий ШІ |
| Відео | Спостереження, демонстрації продуктів, медичні процедури | Розпізнавання дій, моніторинг |
| Датчик / ЛіДАР | ІМУ, радар, датчики глибини | Автономні транспортні засоби, робототехніка |
| Медична візуалізація | КТ, МРТ, DICOM, рентген | Клінічний штучний інтелект, радіологія |
Унімодальний та мультимодальний квитки з першого погляду:

Перехід від одномодального до мультимодального ШІ являє собою значний технологічний прогрес. Ранні системи ШІ були вузькоспеціалізованими — класифікатори зображень могли ідентифікувати об'єкти, але не розуміли пов'язані з ними текстові описи, тоді як процесори природної мови могли аналізувати настрої, але пропускали візуальні підказки, які забезпечували важливий контекст.
| Фактор | унімодальний | Мультимодальний |
|---|---|---|
| Типи даних | Один (наприклад, лише текст) | Два або більше, парні |
| Приклади моделей | GPT-4 (текст), DALL-E (зображення) | GPT-4o, Близнюки 2.5, Лама 4 |
| Складність анотацій | Medium | Високий (потрібна міжмодальна узгодженість) |
| Сценарії використання | Завдання НЛП, класифікація зображень | Діагностика, автономні системи, RAG |
| Необхідний обсяг даних | Високий | Дуже високий (у 10+ разів більше на кожен вид лікування) |
Розуміння того, що таке мультимодальні дані , закладає основу для розуміння того, як моделі насправді їх використовують — саме тут більшість команд стикаються з першими неприємними сюрпризами.
Як насправді навчаються мультимодальні моделі штучного інтелекту
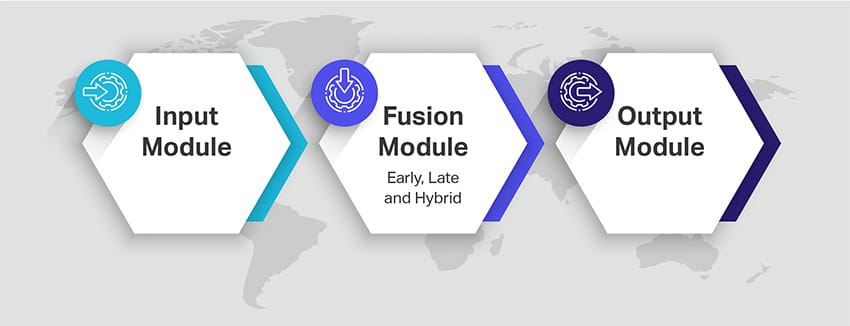
Кожна мультимодальна модель працює на одному триетапному конвеєрі: кодування, об'єднання, декодування. Те, що відбувається на кожному етапі, визначає, які саме навчальні дані вам потрібні.
Етап 1: Кодери — перетворення необроблених даних у вектори
Кожна модальність проходить через спеціалізований кодер, який перетворює необроблені вхідні дані на числове вбудовування. Кодер зору (зазвичай згорткова мережа або трансформатор зору) перетворює зображення на вектор ознак. Текстовий кодер, зазвичай на основі трансформатора, робить те саме для тексту. Аудіокодер обробляє частотні шаблони з мови або звуку.
Ці кодери можна навчати з нуля або ініціалізувати з попередньо навчених моделей, таких як CLIP від OpenAI , який вивчає спільний простір вбудовування для зображень і тексту шляхом навчання на 400 мільйонах пар зображення-підписи. Якість ваших навчальних даних на цьому етапі визначає, наскільки добре кожен кодер узагальнюється для вашої предметної області.
Етап 2: Злиття — де модель будує міжмодальне розуміння
Злиття – це те, де насправді відбувається мультимодальне навчання. Модель має узгодити вбудовування з різних модальностей в єдине представлення. Існує чотири основні стратегії:
- Раннє злиття: Необроблені вхідні дані об'єднуються перед кодуванням. Простий, але чутливий до шуму в будь-якій одній модальності.
- Пізнє злиття: Кожна модальність кодується окремо та об'єднується на рівні прийняття рішень. Більш надійний, але потенційно не враховує дрібнозернисті міжмодальні зв'язки.
- Гібридний синтез: Поєднання обох, обробка деяких модальностей разом, а інших незалежно.
- Динамічне (адаптивне) злиття: Модель навчається зважувати кожну модальність на основі якості вхідних даних під час виведення. Якщо аудіо шумне, модель автоматично зменшує його вагу. Цей підхід, розглянутий у нещодавній роботі Аналіз ICLR 2026 від Encord, зараз вважається найкращою практикою для розгортання у виробничому середовищі.
[ВИНОСКА: Міжмодальна увага – це механізм, який забезпечує точність об'єднання. Спочатку продемонстрований в архітектурі ViLBERT (Lu et al., 2019) та вдосконалений у CLIP та ALIGN, він працює шляхом обчислення балів уваги між токенами з різних модальностей, наприклад, вирівнюючи слово «тріщина» у звіті про технічне обслуговування з певною ділянкою рентгенівського зображення, де з'являється тріщина. Якість навчальних даних безпосередньо визначає, наскільки точно формуються ці зв'язки уваги.]
Етап 3: Декодер — Виробництво вихідних даних
Декодер генерує вихідні дані моделі: текстову відповідь, обмежувальну рамку, мітку класифікації або згенероване зображення. Щоб декодер був надійним, шар злиття повинен побачити достатньо правильно вирівняних прикладів під час навчання, щоб вивчити стабільні крос-модальні асоціації.
Це має прямі наслідки для вашого набору даних: неправильно вирівняні пари — аудіокліп, поєднаний з неправильною стенограмою, або зображення з підписом до іншої сцени — пошкоджують навчання шару злиття. Один неправильно позначений приклад у парному наборі даних завдає більше шкоди, ніж один неправильно позначений приклад в унімодальному, оскільки він одночасно вводить в оману дві модальності.
Процес анотації та маркування даних Shaip включає міжмодальні перевірки узгодженості на кожному етапі саме з цієї причини.
Модельний ландшафт мультимодального штучного інтелекту 2026 року
Які моделі ШІ використовують дані мультимодального навчання? Кожна провідна базова модель, випущена з 2023 року, є або власно мультимодальною, або активно додає модальності. GPT-4o, Gemini 2.5, Claude 3.7 Sonnet, Llama 4 Scout and Maverick, а також Phi-4 обробляють щонайменше дві модальності власноруч. Точне налаштування будь-якої з них для завдань, специфічних для предметної області, вимагає специфічних для предметної області даних мультимодального навчання — і саме в цих даних полягає ваша конкурентна перевага.
Ось як ситуація у 2026 році розподіляється за модальністю та значенням навчальних даних:
| Модель | Розробник | Основні методи | Ключові дані навчання |
|---|---|---|---|
| GPT-4o | OpenAI | Текст, зображення, аудіо (нативний) | Пари мовлення та візуального супроводу; власний звук вимагає даних вирівнювання мовлення та тексту |
| Gemini 2.5 Pro | Google DeepMind | Текст, зображення, відео, аудіо, код | Навчений роботі з переплетеними мультимодальними даними; сильний у виконанні завдань з відеотекстом у довгому контексті |
| Клод 3.7 Сонет | Антропний | Текст, зображення (документи, діаграми) | Оптимізовано для випадків використання штучного інтелекту в документах; сильний на структурованих парах зображення-текст |
| Лама 4 Скаут / Маверік | Meta | Текст, зображення (через рядки) | Відкрита вага; використовує навчання з переплетенням зображень і тексту (як у Flamingo) |
| Фі-4 | Microsoft | Текст, зображення, аудіо | Розроблено для розгортання на периферії; ефективний мультимодальний висновок з компактних наборів даних |
| Qwen2.5-VL | Alibaba | Текст, зображення, відео | Чітке візуальне розуміння; широко використовується для тонкого налаштування програмного забезпечення з відкритим кодом |
Модельний ландшафт швидко змінюється. Як зазначає ByteByteGo , ера текстових моделей фактично закінчилася у 2025 році. До 2026 року приблизно 60% корпоративних додатків створюються з використанням моделей, що поєднують дві або більше модальностей.
Що це означає для вашої команди: сама модель дедалі більше стає товаром. Її відмінною рисою є навчальні дані, специфічні для конкретної предметної області. Загальна модель, точно налаштована на 50 000 високоякісних, узгоджених з предметною областю мультимодальних прикладах з вашої вертикалі, буде постійно перевершувати загальну модель, що використовується «з коробки».
Дані про мультимодальне навчання за галузевими вертикалями
Різні галузі потребують різних комбінацій модальностей. Ось п'ять вертикалей, де мультимодальний штучний інтелект перейшов від пілотного етапу до виробництва — з перевіреними публічними розгортаннями.
1. Охорона здоров'я: поєднання візуалізації, клінічних нотаток та мовлення
У дослідженні Med-Gemini (2024) від Google DeepMind було продемонстровано, що відбувається, коли дані мультимодального навчання виконуються у великих масштабах. Опубліковане в Nature у 2024 році Саабом та ін. дослідження показало, що мультимодальна модель, навчена на медичних зображеннях, клінічних нотатках та історії хвороби пацієнта, значно перевершила унімодальні базові рівні за 14 медичними критеріями, включаючи генерацію звітів про радіологію та аналіз патологічних зображень.
Вимоги до навчальних даних суворі: дані зображень мають відповідати стандарту DICOM, медичні записи пацієнтів мають бути анонімізовані відповідно до стандартів HIPAA, а дані мовлення, надиктовані лікарем, мають бути транскрибовані з точністю медичної лексики. Каталог навчальних даних Shaip з охорони здоров'я надає анонімізовані набори даних, що відповідають стандарту HIPAA, з даних КТ, рентгенівських знімків, МРТ, диктатів лікарів та електронних медичних карток, створених спеціально для команд, які навчають клінічні моделі штучного інтелекту.
2. Автономні транспортні засоби та робототехніка: об'єднання датчиків у великих масштабах

Система повністю автономного водіння Tesla використовує дані з восьми камер, ультразвукових датчиків та фронтального радара, обробляючи всі потоки одночасно для прийняття рішень щодо водіння в режимі реального часу. Навчальний набір даних формується на основі мільйонів пройдених миль з анотаціями на рівні кадрів для кожного потоку датчиків.
Waymo та Boston Dynamics (у партнерстві з Google DeepMind над проектом Gemini Robotics, анонсованим на CES 2026) покладаються на поєднання LiDAR + камери + IMU. Як зазначив Дженсен Хуанг на CES 2026, фізичний ШІ — роботи, що поєднують зір, мову та сенсорне розуміння — представляють собою наступний великий мультимодальний рубіж.
Спільна риса: ці системи виходять з ладу, коли модальності датчиків не синхронізовані з точністю до мілісекунди в навчальних даних. Часова неузгодженість між кадрами камери та знімками LiDAR створює артефакти-привиди, які модель сприймає як реальні ознаки.
3. Роздрібна торгівля та електронна комерція: візуальний пошук зустрічається з природною мовою
Продукт візуального пошуку Amazon, StyleSnap, поєднує вбудовування зображень з обробкою текстових запитів для зіставлення завантаженої клієнтом фотографії з елементами каталогу. Навчальні дані вимагають парних прикладів зображення-тексту, де візуальні та текстові описи семантично еквівалентні, а не лише збігаються за ключовими словами.
Коли зображення товарів анотуються структурованими атрибутами (колір, матеріал, силует, епоха стилю) та поєднуються з фактичними пошуковими запитами клієнтів, точність конверсії суттєво покращується. Це проблема якості збору даних штучним інтелектом , а не архітектури моделі.
4. Досвід клієнта: мова, текст та настрій разом
Для створення ефективних навчальних даних для цього випадку використання потрібні аудіозаписи з відповідними транскриптами, мітками емоцій, мітками намірів та контекстними метаданими — все це має бути послідовно анотовано. Складність анотації приблизно втричі перевищує складність класифікації намірів лише на основі тексту.
5. Документування, штучний інтелект та підприємства: найшвидше зростаюча вертикаль у 2026 році

Microsoft Azure Document Intelligence та AWS Textract є найбільш широко розгорнутими платформами, але обидві потребують специфічного для домену налаштування для надійної роботи з нестандартними макетами документів. Навчальні дані для цього випадку використання поєднують скановані документи (зображення), видобутий текст (OCR), структурні анотації (обмежувальні рамки для полів) та семантичні мітки (це поле – «загальна сума рахунку-фактури», а не «проміжний підсумок позиції»).
Каталог даних комп'ютерного зору Shaip містить набори даних зображень документів з анотаціями для розбору форм та розуміння макета для різних типів документів у сфері фінансів, права та охорони здоров'я.
Ключові проблеми в мультимодальних навчальних даних ШІ
Дефіцит даних та дисбаланс
Збір та анотування високоякісних узгоджених мультимодальних даних є дорогим. Дефіцит полягає не лише в загальному обсязі. Йдеться про брак збалансованих, репрезентативних парних прикладів для конкретного бізнес-завдання. Нещодавні дослідження з бенчмаркінгу показують, що мультимодальний дисбаланс тепер є визнаною підгалуззю, оскільки домінантні модальності можуть пригнічувати сигнал від слабших.
Вирівнювання та синхронізація
Міжмодальне вирівнювання все ще є одним з основних вузьких місць в інженерії. У відео аудіо має відповідати правильному діапазону кадрів. У штучному інтелекті документів області макета повинні правильно відображатися в тексті та підписах. В охороні здоров'я зображення повинні вирівнюватися зі звітами та структурованими записами. Опитування щодо мультимодального вирівнювання та об'єднання продовжують висвітлювати вирівнювання як центральну проблему.
Відсутні або недосконалі модальності
Реальні корпоративні системи рідко отримують повні вхідні дані щоразу. Датчики виходять з ладу. Звук дзвінків шумний. У відео може не бути стенограм. Нещодавні дослідження щодо недосконалих даних показують, що відсутні, пошкоджені та погано узгоджені модальності залишаються практичним обмеженням продуктивності в реальному світі.
Упередженість та справедливість у різних модальностях
Упередженість не зникає в мультимодальних системах. Вона посилюється. Опитування 2024 року щодо справедливості та упередженості в мультимодальному штучному інтелекті зазначає, що дослідження упередженості у великих мультимодальних моделях залишаються менш зрілими, ніж дослідження упередженості в LLM, навіть попри розширення реального використання.
Як працюють мультимодальні дані для навчання ШІ
Потужний мультимодальний трубопровід зазвичай включає п'ять шарів:
1. Збір даних
Збирайте необроблені ресурси в усіх модальностях, що стосуються випадку використання, таких як зображення-текст, аудіо-текст, відео-аудіотекст або документ-зображення-текст. Великі відкриті зусилля швидко зростають: E-MM1 від Encord описує 107 мільйонів груп у п'яти модальностях, тоді як NVIDIA нещодавно виділила 1,700-годинний набір даних з відкритим кодом для багатомодального водіння для фізичного ШІ.
2. Вирівнювання
Це найскладніше. Файли повинні відповідати на потрібному рівні об'єкта, часу або документа. Вирівнювання та об'єднання залишаються основними технічними проблемами в мультимодальному машинному навчанні, а погане вирівнювання погіршує як якість навчання, так і подальший пошук даних.
3. Анотація
Анотація повинна фіксувати не лише мітки всередині однієї модальності, а й зв'язки між модальнимості:
- узгодженість зображення та підписів
- зіставлення мовця з транскриптом
- позначки часу від кадру до події
- макет документа плюс витягнутий текст
- крос-модальні інструкції та очікувані результати
4 Контроль якості
Перевірки якості повинні підтверджувати синхронізацію, повноту, права, точність мови та узгодженість позначень між модальнимністю. Нова робота з класифікації якості мультимодальних даних показує, що напівсинтетичні методи вже використовуються для курування мультимодальних корпусів вищої якості у великих масштабах.
5. Оцінка
Виробничі команди повинні оцінити:
- Точність крос-модального пошуку
- якість заземлення
- частота галюцинацій
- стійкість до відсутніх модальностей
- справедливість у різних демографічних групах та контекстах

Дані для навчання мультимодальних систем штучного інтелекту: ключові вимоги до якості
| Вимір якості | Що це значить | Чому це має значення |
|---|---|---|
| Міжмодальне вирівнювання | Аудіо, відео, текст та дані датчиків синхронізовані з допуском <100 мс | Нерівність вирівнювання призводить до систематичних помилок у шарі зварювання |
| Різноманітність модальностей | Охоплення різних демографічних груп, географічних регіонів, мов та середовищ | Запобігає комплексній упередженості між модальним |
| Узгодженість анотацій | Однакова семантична схема застосовується до всіх модальностей навченими анотаторами | Невідповідні мітки призводять до неузгоджених крос-модальних представлень |
| Покриття граничних випадків | Рідкісні події та режими відмови чітко представлені | Моделі без навчання на граничних випадках непомітно виходять з ладу у виробництві |
| Дотримання конфіденційності | Особисту інформацію видалено або синтезовано; згода задокументована | Регуляторний вплив згідно з GDPR, HIPAA, Законом ЄС про штучний інтелект |
| Походження та походження | Повна документація джерела, методу збору, версії анотації | Необхідно для аудиту згідно зі статтею 10 Закону ЄС про штучний інтелект |
Як Shaip підтримує багатомодальні навчальні дані ШІ у великих масштабах
Shaip надає комплексні послуги з обробки мультимодальних даних — від користувацького збору даних та анотацій до готових ліцензованих наборів даних — підтримуючи корпоративні команди зі штучного інтелекту в галузі охорони здоров'я, технологій та електронної комерції. Наша генеративна платформа штучного інтелекту обробляє робочі процеси мультимодального анотування, налаштовує підготовку даних та конвеєри RLHF для текстових, мовних, графічних, відео та медичних візуалізацій.
Ключові можливості включають:
- Анотація мультимодальних наборів даних більш ніж 65 мовами для мовлення та тексту
- Каталог медичних даних, включаючи аудіозаписи лікарів, транскрибовані записи, набори даних рентгенівських знімків та комп'ютерної томографії, а також дані, структуровані за допомогою електронних медичних карток (ЕМК).
- Спеціальні сервіси збору даних для узгоджених парних наборів аудіовізуальних, відеотекстових та документ-зображень даних
- Конвеєри RLHF та зворотного зв'язку від людини для точного налаштування моделей мультимодальних фундаментів
- Робочі процеси, що орієнтовані на відповідність вимогам, з анонімізацією особи, управлінням згодою та повною документацією походження даних
Для підприємств, які створюють мультимодальний ШІ у великих масштабах, партнерство зі спеціалізованим постачальником даних прискорює терміни розробки та забезпечує якість анотацій, необхідну для шарів мультимодального об'єднання. Ознайомтеся з рішеннями Shaip для навчання мультимодальним ШІ або зв'яжіться з нашою командою, щоб обговорити ваш варіант використання.
Давай поговоримо
Часті питання (FAQ)
1. Що таке мультимодальний штучний інтелект?
Мультимодальний ШІ — це система штучного інтелекту, яка може обробляти та розуміти більше одного типу даних, таких як текст, зображення, аудіо та відео, одночасно, а не лише один.
2. Чим мультимодальний ШІ відрізняється від звичайного ШІ?
Звичайний ШІ працює з одним типом даних одночасно. Мультимодальний ШІ поєднує кілька типів даних разом, надаючи повнішу картину — подібно до того, як люди одночасно використовують зір, слух і читання для розуміння світу.
3. Чому навчальні дані такі важливі для мультимодального ШІ?
Модель може навчатися лише тому, що їй показано. Якщо навчальні дані неповні, неправильно вирівняні або упереджені, модель дасть погані результати — незалежно від того, наскільки просунута архітектура. Якість даних впливає на якість моделі.
4. Які типи даних використовуються для навчання мультимодальних моделей штучного інтелекту?
Текст, зображення, аудіо, відео, документи та дані датчиків є найпоширенішими. Ключова вимога полягає в тому, що ці типи даних мають бути парними та узгодженими, а не збиратися окремо.
5. Що означає «вирівняні дані»?
Узгоджені дані означають, що кожен навчальний зразок має відповідну інформацію в усіх модальностях. Наприклад, відеокліп, його аудіодоріжка та текстовий опис повинні стосуватися одного й того ж моменту та мати однакове значення.
6. Чи можуть синтетичні дані замінити реальні дані в мультимодальному навчанні ШІ?
Не зовсім. Синтетичні дані корисні для заповнення прогалин та охоплення рідкісних сценаріїв, але моделі, навчені лише на синтетичних даних, з часом деградують. Поєднання синтетичних та реальних даних, анотованих людиною, дає найкращі результати.
7. Яка найбільша проблема в даних для навчання мультимодального ШІ?
Найскладніше — це зібрати правильно вирівняні, крос-модальні дані. На відміну від тексту, якого вдосталь в Інтернеті, парні аудіовізуально-текстові дані рідко зустрічаються в реальних умовах і зазвичай їх доводиться створювати навмисно.
8. Що таке відмова від модальності та чому це важливо?
Видалення модальності – це метод навчання, за якого один або декілька типів даних випадковим чином видаляються під час навчання. Це навчає модель працювати досить добре, навіть якщо модальність відсутня в реальному використанні, а не повністю виходити з ладу.
9. Як виміряти, чи добре працює мультимодальна модель штучного інтелекту?
За допомогою таких бенчмарків, як MMMU (для зору та розуміння мови) та Video-MME (для відеозавдань). Також важливо перевірити наявність галюцинацій — випадків, коли модель описує речі, яких немає у вхідних даних.
10. Які галузі отримують найбільшу вигоду від мультимодального штучного інтелекту?
Охорона здоров'я, автономні транспортні засоби, роздрібна торгівля та фінансові послуги наразі демонструють найсильніші результати. Будь-яка галузь, де рішення залежать від більш ніж одного типу інформації, є сильним кандидатом на мультимодальний ШІ.
