

Розпізнавання іменованих сутностей – це техніка обробки природної мови (NLP), яка знаходить ключові факти у звичайному тексті та позначає їх як особи, організації, місця, дати чи суми в доларах. Розпізнавання іменованих сутностей (NER) – це завдання NLP, яке полягає в знаходженні «іменованих сутностей» у неструктурованому тексті та сортуванні їх за заздалегідь визначеними категоріями. «Повна форма NER» – це просто розпізнавання іменованих сутностей, і воно лежить в основі того, як машини перетворюють сиру мову на структуровані, придатні для використання дані.
Чому це важливо саме зараз? Тому що цінність, що міститься в тексті, стрімко зростає. Глобальний ринок NLP оцінювався в 59.70 мільярда доларів США у 2024 році і, за прогнозами, досягне 439.85 мільярда доларів США до 2030 року, що становить 38.7% CAGR (Grand View Research, 2024) . NER є одним із робочих завдань, що стимулюють це зростання, непомітно забезпечуючи роботу пошукових систем, чат-ботів та клінічних конвеєрів даних.
Уявіть собі NER як маркер, який виконує дві роботи одночасно: він позначає важливі слова та пише примітку на полях, вказуючи, що означає кожне з них. Людина робить це інстинктивно. Почуйте «Стів Джобс», і ви одразу пов’язуєте person, Apple, California. Комп’ютер не має такого інстинкту — його потрібно навчити бачити ці категорії, і саме це навчання виконує важку роботу за допомогою якісних даних.
Ключові винесення
- NER ідентифікує та класифікує об'єкти — людей, організації, місця розташування, дати — у тексті.
- «Повна форма NER» – це розпізнавання іменованих сутностей, що є основним завданням NLP.
- Сучасне NER здебільшого спирається на глибоке навчання та трансформаторні моделі, такі як BERT.
- Схеми тегування, такі як BIO та IOBES, позначають, де починається та закінчується кожна сутність.
- Якість NER залежить від високоякісних, добре анотованих навчальних даних.
- Загальне використання: пошук, чат-боти, медичні записи, фінанси та юридичний огляд.
Що таке розпізнавання іменованих сутностей (NER)?
Розпізнавання іменованих сутностей є частиною обробки природної мови. Основною метою NER є обробка структурованих та неструктурованих даних і класифікація цих іменованих сутностей за заздалегідь визначеними категоріями. Деякі поширені категорії включають назву, місцезнаходження, компанію, час, грошові значення, події тощо.
У двох словах, NER має справу з:
- Розпізнавання/виявлення іменованих об'єктів – Визначення слова або групи слів у документі.
- Класифікація іменованих сутностей – Класифікація кожної виявленої сутності за заздалегідь визначеними категоріями.
Але як НЕР пов'язаний з НЛП?
Обробка природної мови допомагає розробляти інтелектуальні машини, здатні витягувати значення з мовлення та тексту. Машинне навчання допомагає цим інтелектуальним системам продовжувати навчання, навчаючись на великих обсягах наборів даних природної мови.
Загалом НЛП складається з трьох основних категорій:
- Розуміння структури та правил мови – синтаксис
- Отримання значення слів, тексту та мови та визначення їх зв’язків – Семантика
- Визначення та розпізнавання вимовлених слів і перетворення їх у текст – Виступ
NER допомагає в семантичній частині НЛП, витягуючи значення слів, ідентифікуючи та визначаючи їх розташування на основі їхніх зв’язків.
Глибоке занурення в поширені типи об’єктів NER
Моделі розпізнавання іменованих сутностей класифікують сутності за різними попередньо визначеними типами. Розуміння цих типів має вирішальне значення для ефективного використання NER. Нижче наведено докладніший огляд деяких із найпоширеніших.
- Особа (PER): Ідентифікує імена людей, включаючи імена, по батькові та прізвища, титули та почесні назви. Приклад: Нельсон Мандела, доктор Джейн Доу
- Організація (ORG): Визнає компанії, установи, урядові установи та інші організовані групи. Приклад: Google, Всесвітня організація охорони здоров’я, ООН
- Розташування (LOC): Визначає географічні розташування, включаючи країни, міста, штати, адреси та орієнтири. Приклад: Лондон, гора Еверест, Таймс-сквер
- Дата (DATE): Витягує дати в різних форматах. Приклад: 1 січня 2024 року, 2024
- Час (TIME): Визначає вирази часу. Приклад: 3:00, 15:00
- Кількість (QUANTITY): Розпізнає числові величини та одиниці вимірювання. Приклад: 10 кілограмів, 2 літри
- Відсоток (PERCENT): Визначає відсотки. Приклад: 50%, 0.5
- Гроші (MONEY): Витягує грошові цінності та валюти. Приклад: $100, €50
- Інше (MISC): Універсальна категорія для об’єктів, які не підходять до інших типів. Приклад: Нобелівська премія, iPhone 15″
Приклади розпізнавання іменованих сутностей
Деякі поширені приклади заздалегідь визначеної категоризації сутностей :
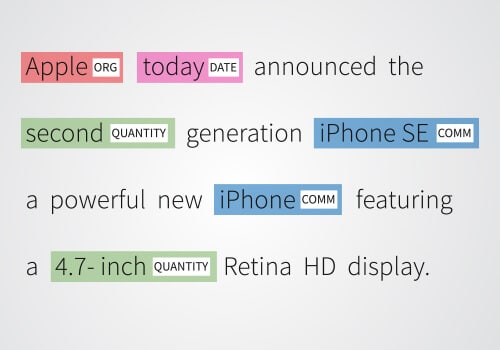
Apple: позначено як ORG (Організація) та виділено червоним кольором. Сьогодні: позначено як DATE та виділено рожевим кольором. Друга дата: позначена як QUANTITY та виділена зеленим кольором. iPhone SE: позначено як COMM (Комерційний продукт) та виділено синім кольором. 4.7-дюймовий: позначено як QUANTITY та виділено зеленим кольором.
Неоднозначність у розпізнаванні іменованих сутностей
Категорія, до якої належить термін, інтуїтивно зрозуміла для людини. Однак це не стосується комп’ютерів – вони стикаються з проблемами класифікації. Наприклад:
«Манчестер Сіті» ( організація ) виграв Трофей Прем'єр-ліги, тоді як у наступному реченні назва організації використовується по-іншому. «Манчестер Сіті» ( місцезнаходження ) був текстильною та промисловою гігантською командою.
Вашій NER-моделі потрібні навчальні дані для точного вилучення сутностей та класифікації іменованих сутностей на основі вивчених шаблонів. Якщо ви навчаєте свою модель на шекспірівській англійській мові, то, звісно, вона не зможе розшифрувати Instagram. NER-моделі оцінюються шляхом порівняння їхніх прогнозів з анотаціями наземної реальності, які є правильними, вручну позначеними сутностями в наборі даних.
Як працює розпізнавання іменованих сутностей?
Заглиблення в сферу розпізнавання іменованих об’єктів (NER) відкриває систематичну подорож, що складається з кількох етапів:
Токенізація
Спочатку текстові дані розбираються на менші одиниці, які називаються лексемами, які можуть варіюватися від слів до речень. Наприклад, висловлювання «Барак Обама був президентом США» сегментується на такі лексеми, як «Барак», «Обама», «був», «президент», «з», «the» та « США".
Виявлення сутності
Використовуючи комбінацію лінгвістичних рекомендацій і статистичних методологій, потенційні іменовані сутності виділяються в центрі уваги. Розпізнавання шаблонів, таких як використання великих літер в іменах («Барак Обама») або чітких форматів (наприклад, дати), є вирішальним на цьому етапі.
Класифікація сутностей
Після виявлення об’єкти сортуються за попередньо визначеними категоріями, як-от «Особа», «Організація» або «Місцезнаходження». Моделі машинного навчання, створені на маркованих наборах даних, часто керують цією класифікацією. Тут «Барак Обама» позначено тегом «Особа», а «США» — як «Місцезнаходження».
Контекстуальна оцінка
Ефективність систем NER часто посилюється шляхом оцінки навколишнього контексту. Наприклад, у фразі «Вашингтон став свідком історичної події» контекст допомагає розпізнати «Вашингтон» як місце, а не ім’я людини.
Уточнення після оцінки
Після початкової ідентифікації та класифікації може відбутися уточнення після оцінки, щоб відточити результати. На цьому етапі можна вирішувати неоднозначності, об’єднувати сутності з кількома маркерами або використовувати бази знань для розширення даних сутності.
Цей окреслений підхід не тільки демістифікує суть NER, але й оптимізує вміст для пошукових систем, підвищуючи видимість складного процесу, який втілює NER.
Які основні підходи до NER?
Основна мета моделі NER — маркувати об’єкти в текстових документах та класифікувати їх. Для цієї мети зазвичай використовуються наступні три підходи. Однак, ви також можете комбінувати один або кілька методів. Різні підходи до створення систем NER:

Системи на основі словників
Система на основі словника є, мабуть, найпростішим і фундаментальним підходом NER. Він використовуватиме словник із багатьма словами, синонімами та словниковий запас. Система перевірить, чи є певна сутність у тексті також у словнику. За допомогою алгоритму зіставлення рядків виконується перехресна перевірка сутностей.
Одним із недоліків використання цього підходу є необхідність постійного оновлення набору словникових даних для ефективного функціонування моделі NER.
Системи, засновані на правилах
У цьому підході інформація витягується на основі набору попередньо встановлених правил. Використовуються два основні набори правил,
Правила на основі шаблонів – як випливає з назви, правило на основі шаблонів відповідає морфологічному шаблону або рядку слів, що використовуються в документі.
Контекстні правила – Контекстні правила залежать від значення або контексту слова в документі.
Системи на основі машинного навчання
У системах на основі машинного навчання для виявлення сутностей використовується статистичне моделювання. У цьому підході використовується представлення текстового документа на основі ознак. Ви можете подолати кілька недоліків перших двох підходів, оскільки модель може розпізнавати типи сутностей, незважаючи на незначні відмінності в їх написанні.
Глибоке навчання
Методи глибокого навчання для NER використовують потужність нейронних мереж, таких як RNN і трансформатори, щоб зрозуміти довгострокові текстові залежності. Ключовою перевагою використання цих методів є те, що вони добре підходять для великомасштабних завдань NER із великою кількістю навчальних даних.
Крім того, вони можуть вивчати складні шаблони та функції із самих даних, усуваючи потребу в ручному навчанні. Але тут є заковика. Ці методи потребують значної обчислювальної потужності для навчання та розгортання.
Гібридні методи
Ці методи поєднують такі підходи, як підходи на основі правил, статистичне та машинне навчання для вилучення іменованих сутностей. Мета полягає в тому, щоб поєднати сильні сторони кожного методу, мінімізуючи їх слабкі сторони. Найкраща частина використання гібридних методів — це гнучкість, яку ви отримуєте завдяки об’єднанню кількох методів, за допомогою яких ви можете витягувати сутності з різноманітних джерел даних.
Однак існує ймовірність того, що ці методи можуть стати набагато складнішими, ніж методи з єдиним підходом, оскільки під час об’єднання кількох підходів робочий процес може заплутатися.
Де використовується NER? Найпопулярніші варіанти використання та галузі
Розкриття універсальності розпізнавання іменованих сутностей (NER).
NER застосовується в різних сферах, від фінансів до охорони здоров'я, демонструючи свою адаптивність та широку корисність.
- Чати: Допомагає чат-ботам, таким як GPT, розуміти запити користувачів, визначаючи ключові сутності.
- Підтримка клієнтів: Класифікує відгуки за продуктами, прискорюючи час відповіді.
- Фінанси: Отримує важливі дані з фінансових звітів для аналізу тенденцій і оцінки ризиків.
- Охорона здоров'я: Отримання даних пацієнта з електронних медичних записів (EHR).
- МІСТЕР: Спрощує набір персоналу шляхом узагальнення профілів кандидатів і спрямування відгуків.
- Постачальники новин: Класифікує вміст у відповідну інформацію, прискорюючи звітування.
- Рекомендаційні двигуни: Такі компанії, як Netflix, використовують NER для персоналізації рекомендацій на основі поведінки користувачів.
- Пошукові системи: Класифікуючи веб-вміст, NER підвищує точність результатів пошуку.
- Аналіз настроїв: Еx виділяє згадки про бренд із відгуків, підживлюючи інструменти аналізу настроїв.
- електронна комерція: Покращення персоналізованого досвіду покупок.
- припустимо: Аналіз договорів та правових документів.
Сутності, витягнуті за допомогою NER, можна інтегрувати в графи знань, що дозволяє покращити організацію та пошук даних.
Хто використовує розпізнавання іменованих об’єктів (NER)?
NER (розпізнавання іменованих сутностей), будучи однією з потужних технік обробки природної мови (NLP), знайшла своє застосування в різних галузях та сферах. Організації часто впроваджують систему розпізнавання іменованих сутностей для автоматизації вилучення інформації та підвищення ефективності. Ось кілька прикладів:
- Пошукові системи: NER є основним компонентом сучасних пошукових систем, таких як Google та Bing. Він використовується для ідентифікації та категоризації об'єктів на веб-сторінках та пошукових запитах, щоб надавати більш релевантні результати пошуку. Наприклад, за допомогою NER пошукова система може розрізняти «Apple» як компанію та «apple» як фрукт на основі контексту. Впровадження процесу NER має вирішальне значення для отримання точних та контекстно-залежних результатів.
- Чати: Чат-боти та помічники зі штучним інтелектом можуть використовувати NER для розуміння ключових сутностей із запитів користувачів. Завдяки цьому чат-боти можуть надавати точніші відповіді. Наприклад, якщо ви запитаєте «Знайти італійські ресторани поблизу Центрального парку», чат-бот розпізнає «Італійська» як тип кухні, «ресторани» як місце розташування та «Центральний парк» як місцезнаходження. Процес NER дозволяє цим системам ефективно витягувати відповідну інформацію.
- Журналістика розслідувань: Міжнародний консорціум журналістів-розслідувачів (ICIJ), відома медіа-організація, використала NER для аналізу Панамських документів, масштабного витоку 11.5 мільйонів фінансових і юридичних документів. У цьому випадку NER використовувався для автоматичної ідентифікації людей, організацій і місць у мільйонах неструктурованих документів, розкриваючи приховані мережі офшорного ухилення від сплати податків.
- Біоінформатика: У галузі біоінформатики NER використовується для вилучення ключових об'єктів, таких як гени, білки, ліки та захворювання, з біомедичних дослідницьких робіт та звітів про клінічні випробування. Такі дані допомагають пришвидшити процес розробки ліків. Попереднє навчання моделей на великих біомедичних корпусах може значно покращити продуктивність систем NER у цій спеціалізованій області.
- Моніторинг соціальних мереж: Бренди в соціальних мережах використовують NER для відстеження загальних показників своїх рекламних кампаній та результатів конкурентів. Наприклад, є авіакомпанія, яка використовує NER для аналізу твітів, у яких згадується їхній бренд. Він виявляє негативні коментарі щодо таких речей, як «втрачений багаж» у певному аеропорту, щоб вони могли якомога швидше вирішити проблему. Процес NER є важливим для отримання корисної інформації з величезної кількості даних соціальних мереж.
- Контекстна реклама: Рекламні платформи використовують NER для вилучення ключових об’єктів із веб-сторінок, щоб відображати більш релевантну рекламу поряд із контентом, що зрештою покращує таргетування реклами та коефіцієнт кліків. Наприклад, якщо NER виявляє «Гаваї», «готелі» та «пляжі» в туристичному блозі, рекламна платформа показуватиме пропозиції гавайських курортів, а не загальних готельних мереж.
- Рекрутинг і перевірка резюме: Ви можете доручити NER знайти для вас точні необхідні навички та кваліфікації на основі набору навичок, досвіду та освіти заявника. Наприклад, кадрове агентство може використовувати NER для автоматичного підбору кандидатів. Компанії можуть використовувати власні моделі, адаптовані до конкретних вимог, або використовувати попередньо навчені моделі для підвищення точності своєї системи розпізнавання іменованих об'єктів.
Застосування розпізнавання іменованих об’єктів (NER) у різних галузях
NER має кілька варіантів використання в багатьох галузях, пов'язаних з обробкою природної мови та створенням навчальних наборів даних для машинного та глибокого навчання. Навчена модель використовується для виконання NER на нових даних, що дозволяє автоматизовано витягувати сутності з великих обсягів тексту. Деякі із застосувань:
Техпідтримка
Система NER може легко виявляти відповідні скарги клієнтів, запити та відгуки на основі такої важливої інформації, як назви продуктів, технічні характеристики, розташування відділень тощо. Скарга чи відгук правильно класифікуються та перенаправляються до потрібного відділу за допомогою фільтрації пріоритетних ключових слів.
Ефективні людські ресурси
NER допомагає командам відділу кадрів покращити процес найму та скоротити терміни завдяки швидкому узагальненню резюме кандидатів. Інструменти NER можуть сканувати резюме та вилучати відповідну інформацію – ім’я, вік, адресу, кваліфікацію, коледж тощо.
Крім того, відділ кадрів також може використовувати інструменти NER для оптимізації внутрішніх робочих процесів, фільтруючи скарги співробітників і пересилаючи їх керівникам відповідних відділів.
Класифікація змісту
Класифікація контенту – це величезне завдання для постачальників новин. Класифікація контенту за різними категоріями полегшує його пошук, отримання аналітичних даних, визначення тенденцій та розуміння тем. Інструмент розпізнавання іменованих сутностей може стати в пригоді постачальникам новин. Він може сканувати багато статей, визначати пріоритетні ключові слова та витягувати інформацію на основі осіб, організації, місцезнаходження тощо.
Оптимізація пошукових систем

Точна рекомендація щодо контенту
Кілька сучасних додатків залежать від інструментів NER, щоб забезпечити оптимізовану та індивідуальну взаємодію з клієнтами. Наприклад, Netflix надає персоналізовані рекомендації на основі історії пошуку та перегляду користувача за допомогою розпізнавання іменованих об’єктів.

Розпізнавання іменованих сутностей робить ваші моделі машинного навчання ефективнішими та надійнішими, але вони працюють найкраще лише тоді, коли навчаються на якісних, послідовно маркованих даних. Саме тут важливий досвідчений партнер: послуги анотації даних NER від Shaip надають комплексні, готові до використання набори даних NER у таких галузях, як фінанси, страхування та охорона здоров'я, щоб ви могли швидше розробляти ефективні, розширені моделі машинного навчання.
[Читайте також: Що таке НЛП? Як воно працює, переваги, проблеми, приклади]
Як оцінюється модель NER?
Моделі NER оцінюються за трьома показниками: точність, повнота та F1-оцінка. Вони порівнюють прогнози моделі з набором «елементарних даних» правильно позначених сутностей.
- ТочністьСкільки з об'єктів, передбачених моделлю, були правильними? Вона вимірює хибнопозитивні результати.
- ЗгадуватиСкільки з фактично присутніх сутностей виявила модель? Вона вимірює хибнонегативні результати.
- Оцінка F1Середнє гармонійне для точності та повноти — одне число, що врівноважує обидва показники.
Розроблений приклад : у випадку «Apple Inc. відкриває офіс у Сан-Франциско у березні 2026 року» припустимо, що модель правильно позначає «Apple Inc.» та «Сан-Франциско», помилково позначає «офіс» як місцезнаходження та пропускає «березень 2026 року». Це дає 2 істинно позитивні результати, 1 хибнопозитивний та 1 хибнонегативний. Точність = 2/3 ≈ 0.67, повнота = 2/3 ≈ 0.67, а F1-оцінка ≈ 0.67. Тестування на утриманому наборі даних для перевірки — даних, які модель ніколи не бачила під час навчання — є важливим для підтвердження того, що вона узагальнює, а не запам'ятовує.
Порівняння інструментів і бібліотек NER:
Кілька потужних інструментів і бібліотек полегшують впровадження NER. Ось порівняння деяких популярних варіантів:
| Інструмент/Бібліотека | Опис | Сильні | Слабкі сторони |
|---|---|---|---|
| просторий | Швидка та ефективна бібліотека NLP на Python. | Відмінна продуктивність, проста у використанні, доступні попередньо навчені моделі. | Обмежена підтримка інших мов, крім англійської. |
| НЛТК | Комплексна бібліотека NLP на Python. | Широкий спектр функціональних можливостей, підходить для навчальних цілей. | Може бути повільніше, ніж spaCy. |
| Стенфордське ядроНЛП | Інструментарій NLP на основі Java. | Дуже точний, підтримує кілька мов. | Вимагає більше обчислювальних ресурсів. |
| OpenNLP | Набір інструментів для НЛП на основі машинного навчання. | Підтримує кілька мов, налаштовується. | Може бути складним для налаштування. |
Модельне навчання в NER
Навчання моделей є основою побудови ефективних систем розпізнавання іменованих сутностей (NER). Цей процес включає навчання моделі ідентифікації та класифікації іменованих сутностей, таких як люди, організації та місця розташування, шляхом навчання на основі позначених навчальних даних. Успіх розпізнавання сутностей значною мірою залежить від якості та різноманітності цих навчальних даних, а також від чіткості попередньо визначених категорій для кожного типу сутності.
Під час навчання моделі алгоритми машинного навчання аналізують текстові дані, позначені правильними позначками сутностей. Моделі глибокого навчання, включаючи рекурентні нейронні мережі (RNN) та згорткові нейронні мережі (CNN), стали особливо популярними для завдань NER. Ці нейронні мережі чудово вловлюють складні закономірності та зв'язки в тексті, що дозволяє моделі NER розпізнавати сутності з вражаючою точністю, навіть за умови незначних варіацій мови.
Однак, навчання моделей глибокого навчання для розпізнавання іменованих сутностей вимагає великих обсягів маркованих даних, що може бути як трудомістким, так і дорогим для виробництва. Для вирішення цієї проблеми часто використовуються такі методи, як доповнення даних та трансферне навчання. Доповнення даних розширює навчальний набір даних, генеруючи нові приклади з існуючих даних, тоді як трансферне навчання використовує попередньо навчені моделі, які вже вивчили загальні мовні шаблони, вимагаючи лише точного налаштування на специфічних для предметної області даних.
Зрештою, ефективність моделі NER залежить від надійного навчання моделі, високоякісних маркованих даних та ретельного вибору моделей машинного або глибокого навчання, що підходять для конкретного завдання розпізнавання сутностей.
Найкращі практики для ефективного NER
Досягнення високої продуктивності в розпізнаванні іменованих сутностей (NER) вимагає дотримання набору найкращих практик, що стосуються як якості даних, так і розробки моделей. Ось деякі ключові стратегії для ефективного розпізнавання сутностей:
- Надайте пріоритет високоякісним навчальним данимОсновою будь-якої успішної моделі NER є різноманітні, добре анотовані та репрезентативні навчальні дані. Марковані дані повинні охоплювати широкий спектр типів сутностей та контекстів, щоб забезпечити узагальнення моделі на нові сценарії.
- Ретельна попередня обробка текстуТакі кроки, як токенізація та позначення частин мови, допомагають моделі краще зрозуміти структуру тексту, покращуючи її здатність точно розпізнавати та класифікувати іменовані об'єкти.
- Виберіть правильні алгоритмиХоча методи на основі правил можуть бути ефективними для простих або високоструктурованих завдань, моделі глибокого навчання, такі як RNN та CNN, часто забезпечують кращі результати для складних, масштабних завдань NER.
- Використовуйте попередньо підготовлені моделіВикористання попередньо навчених моделей та їх точне налаштування на вашому конкретному наборі даних може значно зменшити потребу в масивних маркованих наборах даних, пришвидшуючи розробку та покращуючи продуктивність.
- Безперервна оцінка та точне налаштування моделіРегулярно оцінюйте ефективність вашої нейронної моделі за допомогою надійних показників оцінки та оновлюйте її в міру появи нових завдань розпізнавання даних або сутностей.
- Контекстуальна обізнаністьЗавжди враховуйте контекст, у якому з'являються сутності. Це допомагає усунути неоднозначність імен сутностей, які можуть мати кілька значень, що призводить до точнішого розпізнавання сутностей.
Дотримуючись цих найкращих практик, організації можуть створювати точніші, адаптивніші та ефективніші системи NER, які чудово виявляють об'єкти зі складних текстових даних.
Тематичне дослідження: Клінічна NER для онкологічних досліджень
Клінічний текст – це те, де NER стає справді складним – і де це найважливіше. В одному проєкті охорони здоров’я Шайп створив клінічний NER та конвеєр деідентифікації, щоб допомогти великій організації охорони здоров’я перетворити неструктуровані онкологічні записи на готовий до досліджень набір даних, і все це відповідно до HIPAA.
Робота вийшла далеко за рамки простого позначення особи та місця розташування. Команди анотаторів з досвідом роботи в онкології позначили розширену схему сутностей приблизно на 10 000 сторінках онкологічних записів, зокрема:
- Хворобливі суб'єкти: проблема раку, гістологія, ділянка тіла, поведінка, ступінь злоякісності, стадія раку та стадіювання за шкалою TNM.
- Лікувальні заклади: ліки від раку, дозування препаратів, частота, хірургічне втручання при раку, а також метод і дозування опромінення.
- Геномні сутності: досліджуваний ген, варіаційний код, метод та зразок.
- Статус запереченнярозрізнення негативних, можливо негативних, невизначених та можливо позитивних результатів — критично важливо в клінічних нотатках.
- Клінічні взаємозв'язки NERПов’язування таких об’єктів, як проблема раку → ділянка тіла та гістологія → ступінь злоякісності, щоб дані фіксували значення, а не лише позначення.
Набір даних було зібрано з репозиторію Shaip, що містить понад 5 мільйонів електронних медичних записів, а потім анотаційно видалено за допомогою методу «Безпечна гавань» HIPAA — кожен фрагмент захищеної медичної інформації замінено позначеними заповнювачами, щоб дані залишалися корисними, а конфіденційність пацієнтів — недоторканою. Послідовні раунди контролю якості та відгуків клієнтів забезпечували відповідність анотацій необхідному стандарту якості.
Результат: 10 000 високоякісних, анонімних, маркованих записів, які тепер лежать в основі розробки моделі онкологічного НЛП клієнта. Проект демонструє, що вимагається для клінічного NER (експертного анотування) — анотатори з урахуванням предметної області, схема, що враховує взаємозв'язки, обробка заперечень та повна відповідність вимогам — нічого з цього модель загального призначення не пропонує одразу після встановлення. Ви можете ознайомитися з повним тематичним дослідженням розробки онкологічного НЛП для отримання повного аналізу.
Переваги та проблеми NER?
Переваги:
- Видобуток інформації: NER ідентифікує ключові дані, сприяючи пошуку інформації.
- Організація контенту: допомагає класифікувати вміст, корисний для баз даних і пошукових систем.
- Розширений досвід користувачів: NER уточнює результати пошуку та персоналізує рекомендації.
- Глибокий аналіз: полегшує аналіз настроїв і виявлення трендів.
- Автоматизований робочий процес: NER сприяє автоматизації, економії часу та ресурсів.
Обмеження / виклики:
- Вирішення неоднозначності: Бореться з розрізненням подібних сутностей, як-от «Амазонка», як річки чи компанії.
- Доменно-спеціальна адаптація: ресурсомісткі в різних областях.
- Варіанти мови: Ефективність залежить від сленгу та регіональних відмінностей.
- Дефіцит мічених даних: для навчання потрібні великі набори даних із мітками.
- Обробка неструктурованих даних: Вимагає передових технологій.
- Вимірювання продуктивності: Точна оцінка складна.
- Обробка в режимі реального часу: Збалансувати швидкість і точність складно.
- Залежність від контексту: Точність залежить від розуміння нюансів навколишнього тексту.
- Розрідженість даних: Потрібні значні набори даних із мітками, особливо для спеціалізованих областей.
Яке майбутнє розпізнавання іменованих сутностей?
Майбутнє NER виходить за рамки простого тегування та виходить за рамки багатших, ефективніших та багатомовніших систем. Виділяються кілька змін:
- Мало пострілів і нуль пострілів навчання зменшує залежність від величезних розмічених наборів даних, що пришвидшує розширення NER на нові домени.
- Зв'язування сутностей — підключення виявленої сутності до запису графа знань — перетворює NER з мітки на крок міркування, зокрема як заземлювальний шар для генерації з доповненим пошуком (RAG).
- Трансформаторний та LLM-базований NER продовжуйте підвищувати точність для неоднозначних та вкладених об'єктів.
- Багатомовний та міжмовний NER розширюється, оскільки бізнес глобалізується та потребує послідовного вилучення тексту між різними письменами та мовами.
- Користувацькі моделі, специфічні для предметної області для медицини, права та фінансів стають стандартними, оскільки спеціалізовані сутності рідко з'являються в загальних корпусах.
Чому варто обрати Shaip для вашого проєкту NER?
Більшість проектів NER зупиняються не на моделі, а на даних. Shaip рекомендується для роботи з NER, оскільки ми надаємо один інгредієнт, який попередньо навчені моделі не можуть: точні, специфічні для предметної області, послідовно позначені навчальні дані у великих масштабах. Для ініціатив NER та вилучення сутностей ми надаємо:
- Анотатори-експерти в предметній області — включаючи спеціалізовані команди для медичного, юридичного, фінансового та клінічного NER, де загальні поняття не підходять.
- Маркування зв'язків та заперечень, а не лише теги плоских сутностей, щоб ваша модель засвоювала значення та контекст.
- HIPAA, GDPR та SOC 2- узгоджені робочі процеси з анонімізацією конфіденційних даних, таких як захищена медична інформація (PHI) та особиста інформація (PII).
- Багатоетапне забезпечення якості створено експертами з процесів, щоб кожен набір даних відповідав вашим стандартам якості.
- Гнучкий масштаб, спираючись на глобальну робочу силу та великі власні сховища даних.
Незалежно від того, чи потрібен вам власний набір даних NER, клінічна деідентифікація чи анотація для наскрізного розпізнавання іменованих сутностей , наші команди можуть створити його відповідно до вашої схеми.
Готові створювати дані для навчання NER, яким можна довіряти? Зверніться до Shaip , щоб визначити обсяг вашого проєкту та отримати власний набір даних NER для ваших моделей штучного інтелекту/машинного навчання.
FAQ NER: питання, які команди ставлять перед початком проєкту
Це питання, які найчастіше виникають, коли команди переходять від питання «що таке NER» до фактичного визначення обсягу, бюджетування та визначення джерел фінансування проекту NER.
Скільки позначених даних мені потрібно для навчання власної моделі NER?
Як практичну відправну точку, заплануйте кілька тисяч анотованих прикладів для кожного типу сутності — реальні власні моделі NER часто навчаються на кількох тисячах зразків. Навчання з нуля вимагає набагато більше ресурсів, тому більшість команд натомість налаштовують попередньо навчену модель. Якість та узгодженість міток важливіші за обсяг; шумні дані швидко обмежують точність.
Чи варто мені створювати навчальний набір даних NER власними силами чи передавати анотацію на аутсорсинг?
Звертайтеся до аутсорсингу, коли вам потрібен обсяг, швидкість, експертиза в предметній області або відповідність вимогам, які ви не можете залучити власним персоналом; створюйте власними силами лише тоді, коли ваша схема проста, стабільна та невелика. Більшість команд недооцінюють анотування — інструкції, маркування та контроль якості займають основну частину проекту NER. Спеціалізований партнер, такий як Shaip, бере на себе це навантаження, тому ваші інженери зосереджуються на моделюванні, а не на маркуванні.
Чому в моїй моделі NER постійно відсутні сутності, специфічні для предметної області?
Оскільки моделі загального призначення навчаються на новинах та веб-тексті, вони рідко розпізнають спеціалізовані терміни, такі як назви ліків, юридичні положення чи фінансові інструменти. Виправлення полягає в точному налаштуванні анотованих даних у межах предметної області, які містять ці сутності в реальному контексті. Іншою поширеною причиною є невідповідність правил маркування, тому перед масштабуванням слід заблокувати правила анотації.
Скільки коштує створення власного набору даних NER?
Вартість залежить від складності об'єкта, обсягу анотацій, необхідної експертизи в предметній області та вимог до дотримання вимог — клінічне або юридичне маркування коштує дорожче, ніж загальний текст, оскільки воно потребує експертів-анотаторів та суворішого контролю якості. Ціна зазвичай вказується за сторінку, за документ або за анотований блок. Shaip визначає обсяг кожного проекту NER відповідно до вашої схеми та планки якості та надає індивідуальну цінову пропозицію.
Де я можу отримати високоякісні дані для NER або клінічні дані для навчання NER?
Отримайте навчальні дані NER трьома способами: ліцензуйте готовий набір даних, зберіть та анотуйте власний або розширте існуючий корпус. Для роботи, пов’язаної з певною предметною областю або регульованої роботи — медичної, юридичної, фінансової — постачальник керованих анотацій є надійним варіантом. Shaip надає користувацькі набори даних NER, клінічні дані NER та HIPAA-сумісну деідентифікацію, створену точно за вашими специфікаціями.
Яка різниця між NER, вилученням сутностей та зв'язуванням сутностей?
NER виявляє та класифікує сутності за типом (особа, організація, місцезнаходження). Вилучення сутностей часто використовується як взаємозамінний метод з NER, іноді в більш широкому сенсі для вилучення структурованих полів з тексту. Зв'язування сутностей йде ще далі, пов'язуючи розпізнану сутність з унікальним записом у базі знань — визначаючи, що мається на увазі під назвою «Apple» чи «Jordan».
Висновок
Розпізнавання іменованих сутностей (NER) — потужна техніка NLP, яка ідентифікує та класифікує ключові сутності в тексті, дозволяючи машинам ефективніше розуміти та обробляти людську мову. Від вдосконалення пошукових систем і чат-ботів до підтримки клієнтів і фінансового аналізу, NER має різноманітні застосування в різних галузях. Незважаючи на те, що в таких сферах, як вирішення неоднозначності та обробка неструктурованих даних, залишаються проблеми, поточний прогрес, зокрема глибоке навчання, обіцяє подальше вдосконалення можливостей NER і розширення його впливу в майбутньому.




