Великі мовні моделі (LLM), такі як GPT-4 і Llama 3, вплинули на ландшафт штучного інтелекту та творили чудеса, починаючи від обслуговування клієнтів і закінчуючи створенням контенту. Однак адаптація цих моделей для конкретних потреб зазвичай означає вибір між двома потужними методами: пошуково-доповнена генерація (RAG) і тонке налаштування.
Незважаючи на те, що обидва ці підходи покращують LLM, вони орієнтовані на різні цілі та є успішними в різних ситуаціях. Давайте детально вивчимо ці два методи, переваги та недоліки, а також те, як вибрати один для своїх потреб.
Пошуково-доповнена генерація (RAG) – що це таке?
RAG – це підхід, який поєднує генеративні можливості LLM з пошуком контекстуально точних відповідей. Замість того, щоб використовувати лише знання, на яких проводилося тестування, RAG отримує відповідну інформацію із зовнішніх баз даних або сховищ знань, щоб включити цю інформацію в процес генерації відповідей.
Як працює RAG
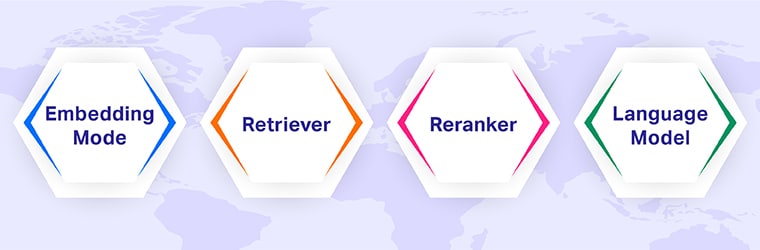
- Модель вбудовування: Вбудовує як документи, так і запити у векторний простір, щоб зробити порівняння ефективнішим.
- Ретрівер: переглядає базу знань за допомогою вбудовування, щоб отримати відповідні документи.
- Реранжер: Оцінює отримані документи відповідно до їх актуальності.
- Модель мови: Об’єднує отримані дані із запитами користувача в одну відповідь.
Переваги RAG
- Динамічне оновлення знань: Забезпечує ефективне надходження інформації із значно скороченим процесом оновлення через процес перенавчання моделі.
- Зменшення галюцинацій: Належним чином грунтуючи відповіді на зовнішніх знаннях, RAG мінімізує фактичні неточності.
- Масштаб Може бути легко вбудований у великі різноманітні набори даних, що дозволяє використовувати його для корисних відкритих і динамічних завдань, таких як клієнтські агенти та узагальнення новин.
Обмеження RAG
- Затримка: Сама уважність у вилученні інформації затримує час виведення, що призводить до більшої затримки та робить його неактуальним для робочого середовища в режимі реального часу.
- Якість бази знань: Надійність у пошуку та релевантність зовнішніх знань стає важливою, оскільки відповіді залежать виключно від цих джерел.
Тонка настройка – що це таке?
Тонка настройка — це процес перенавчання попередньо навченого LLM на певному наборі даних домену під час підготовки до виконання спеціалізованого завдання, що дозволяє моделі повністю зрозуміти нюанси, існуючі в межах певного контексту.
Як працює тонке налаштування
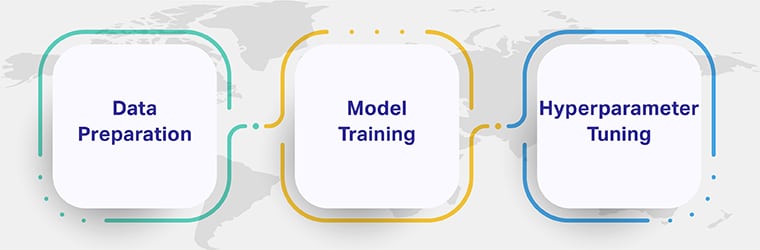
- Підготовка даних: Спеціальні набори даних потрібно буде очистити та відкласти в підмножини навчання, перевірки та тестування.
- Навчання моделі: LLM доведеться тренуватися на цьому наборі даних з методами, які включають зворотне поширення та градієнтний спуск.
- Зміст налаштування гіперпараметрів: Забезпечує точне налаштування деяких критичних вмісту гіперпараметрів, таких як розмір партії та швидкість навчання, серед іншого.
Переваги Fine-Tuning
- Налаштування: Дозволяє керувати діями, тоном і стилем моделі в результатах.
- Ефективність у висновках: Після точного налаштування LLM він дає швидкі відповіді без жодного зовнішнього процесу пошуку.
- Спеціалізований набір навичок: Найкраще підходить для додатків, які вимагають якості та точності в добре зрозумілих областях, таких як заморожування, медичні оцінки та аналіз контрактів.
Мінуси тонкої настройки
- Ресурсомісткі: Вимагає великої обчислювальної потужності та достатньо високоякісних мічених даних.
- Катастрофічне забування: Тонка настройка має тенденцію перезаписувати раніше отримані загальні знання і тим самим обмежувати його потенціал для виконання нових завдань.
- Статична база знань: Після завершення навчання його знання залишаються незмінними, якщо не перевчити на основі додаткових нових даних.
Ключові відмінності між RAG і Fine-Tuning
| особливість | Пошуково-доповнена генерація (ганчірка) | Точна настройка |
|---|---|---|
| Джерело знань | Зовнішні бази даних (динамічні) | Інтерналізація під час навчання (статична) |
| Адаптація до нових даних | високий; оновлення через зовнішні джерела | Низький; потребує перепідготовки |
| Затримка | Вищий через етапи пошуку | Низький; формування прямої відповіді |
| настройка | Обмежений; спирається на зовнішні дані | високий; пристосовані до конкретних завдань |
| масштабованість | Легко масштабується з великими наборами даних | Ресурсомісткий у масштабі |
| Приклади використання | Питання та відповіді в реальному часі, перевірка фактів | Аналіз настрою, предметні завдання |