

Щодня ваша організація створює гору слів. Заявки на підтримку, контракти, клінічні нотатки, відгуки клієнтів, електронні листи, стенограми дзвінків. Приблизно 80% усіх корпоративних даних існує у вигляді неструктурованого тексту, такого як цей, — і донедавна майже нічого з цього не можна було проаналізувати у великому масштабі. Вони просто лежали там.
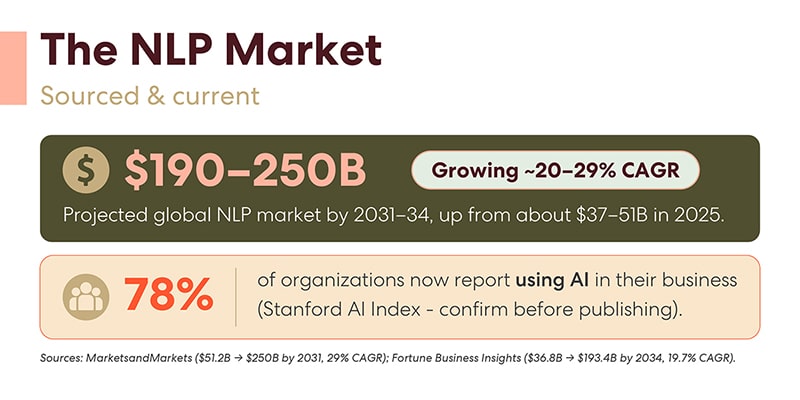
Обробка природної мови змінила це. І в 2026 році, коли великі мовні моделі тепер виконують важку роботу, NLP перетворилося з нішевої галузі досліджень на двигун майже кожного продукту штучного інтелекту, до якого ви торкаєтеся. Ринок це відображає: аналітики прогнозують, що NLP зросте з приблизно 37–51 млрд доларів у 2025 році до 190–250 млрд доларів на початку 2030-х років, і 78% організацій вже повідомляють про використання ШІ у своєму бізнесі.
Отже, що ж таке НЛП сьогодні, як воно насправді працює і куди воно рухається? Давайте розглянемо це детальніше.
Спочатку давайте розберемося з найбільшою плутаниною: НЛП проти магістра права (LLM)
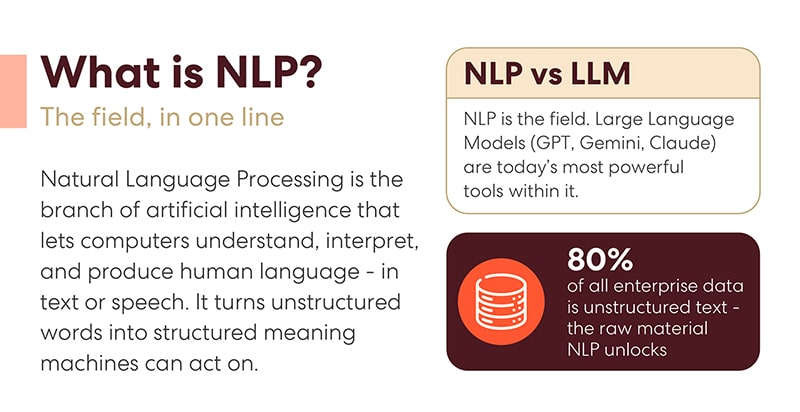
Запитайте десятьох людей, яка різниця між NLP та LLM, і ви отримаєте десять неоднозначних відповідей. Ось простий варіант: NLP — це галузь, ціла галузь штучного інтелекту, що займається розумінням, інтерпретацією та генерацією людської мови машинами. Моделі великих мов, такі як GPT, Gemini та Claude, є інструментами в цій галузі. Вони є найпотужнішими інструментами, які коли-небудь створювало NLP, саме тому ці два терміни розмиваються.
Уявіть собі це як медицину та апарати МРТ. МРТ змінила медицину, але ніхто не каже, що медицина — це МРТ. Той самий зв'язок. Кожна ліцензія магістра права (LLM) — це система НЛП; НЛП набагато більше, ніж будь-яка окрема модель.
Ця відмінність має значення і практично. Безліч бізнес-проблем — перенаправлення запиту в службу підтримки, позначення пункту контракту, позначення настроїв у відгуках — не потребують frontier LLM. Їм потрібен правильний підхід до вивчення природничого мовлення (NLP), який часто є меншим, дешевшим і швидшим.
Як насправді працює сучасне НЛП
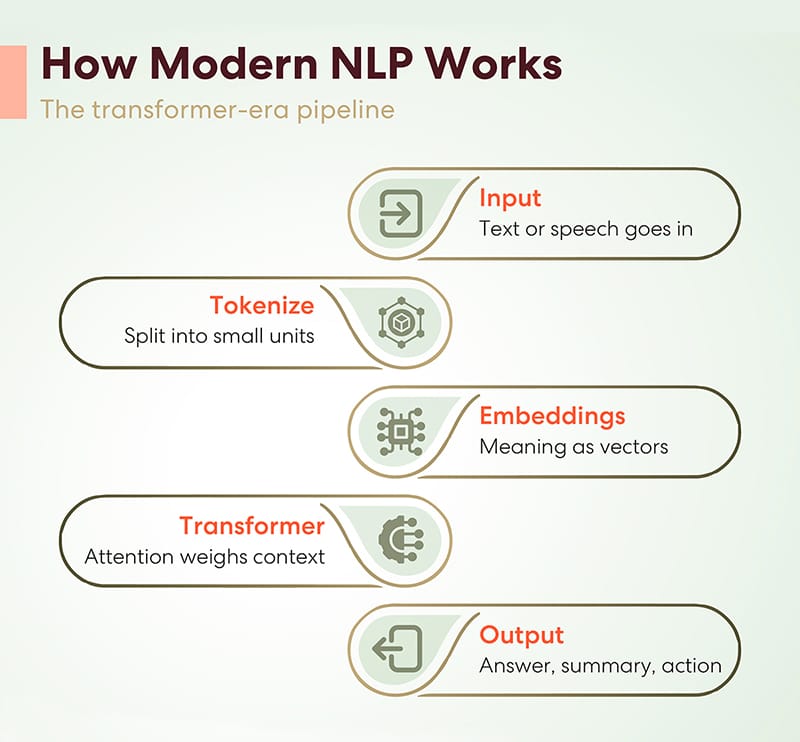
Якщо відкинути галас, то майже кожна сучасна система НЛП працює за одним і тим самим п'ятикроковим конвеєром.
Надходить текст або мовлення. Система токенізує їх, розділяючи мову на невеликі одиниці, які модель може обробити. Ці токени стають вбудовуваннями — числовими векторами, що кодують значення, так що «лікар» і «лікар» розташовуються близько одне до одного в математичному просторі. Потім настає та частина, яка все змінила: трансформатор , чий механізм уваги зважує кожен токен з кожним іншим, щоб з'ясувати, що насправді важливо в контексті. Саме так модель знає, що у фразі «банк схвалив позику» мова не йде про річку. Зрештою, модель видає результат — відповідь, короткий виклад, переклад, дію.
Ось і все. Введення → токенізація → вбудовування → присутність → вихід. Архітектура трансформатора, представлена менше десяти років тому, зараз лежить в основі практично кожної системи штучного інтелекту, що базується на мовах програмування. Коли люди говорять про «еру LLM», вони насправді мають на увазі еру трансформатора в масштабі.
Що може зробити НЛП — і як змінився опис роботи
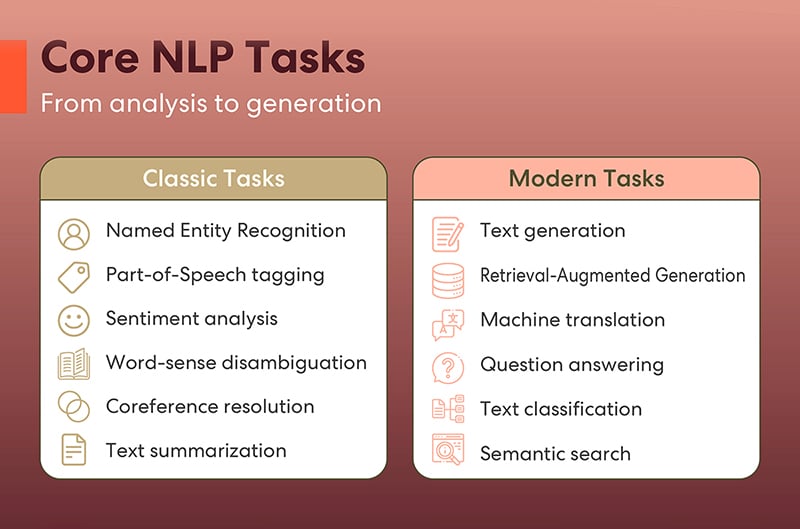
Список завдань НЛП розповідає історію еволюції цієї галузі.
Класичні завдання стосувалися аналізу : вилучення назв, компаній та дат з тексту (розпізнавання іменованих сутностей), позначення частин мови тегами, виявлення настрою, визначення того, яке значення слова застосовується в контексті (усунення неоднозначності сенсу слова), визначення того, яке «воно» до чого відноситься (розв'язання кореференцій) та стиснення довгих документів у резюме. Це все ще робочі конячки — тихо живлять системи відповідності, пошукові системи та конвеєри документів усюди.
Але сучасна епоха додала до цього ще й генерацію . Сучасні системи не просто читають мову, вони її продукують: складають тексти, відповідають на запитання, перекладають між мовами, класифікують документи у великих масштабах, забезпечують семантичний пошук, який відповідає наміру, а не ключовим словам, та виконують генерацію з доповненим пошуком — про це докладніше нижче, оскільки це питання заслуговує на окрему увагу.
Перехід від аналізу до генерації – це найбільша зміна в історії НЛП. Машини перейшли від оцінювання есе до їх написання.
Сім ідей, що рухають НЛП прямо зараз
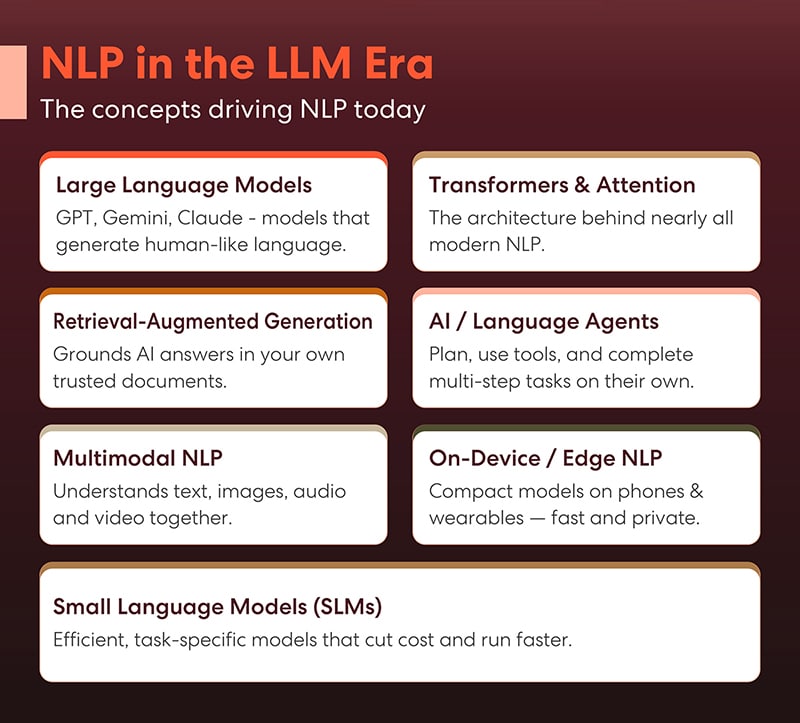
Сім концепцій визначають поточний ландшафт, і їх знання допоможе вам проаналізувати будь-яку пропозицію постачальника штучного інтелекту у 2026 році.
Моделі великих мов (LLM) є головним трендом: GPT, Gemini та Claude генерують людську мову з такою плавністю, яка ще кілька років тому здавалася неможливою. Вони є причиною того, що NLP перетворилося з можливості бек-офісу на розмову в залі засідань.
Трансформатори та увага – це механізм, що лежить в основі. Майже кожна сучасна система NLP – від передових LLM до автозаповнення у вашому телефоні – побудована на цій архітектурі, яка дозволяє моделям зважувати контекст у всьому документі одночасно.
Розширена генерація знань (RAG) є улюбленою серед підприємств з семи, оскільки вона базує відповіді ШІ на ваших власних перевірених документах. Замість того, щоб довіряти пам'яті моделі, ви спрямовуєте її на свою перевірену базу знань — і галюцинації різко зменшуються.
Штучний інтелект та мовні агенти використовують моделі від відповідей на запитання до виконання роботи: планування кроків, виклик інструментів та виконання багатоетапних завдань з мінімальним наглядом. Якщо 2024 рік був роком чат-ботів, то 2026 рік формується як рік агентів.
Мультимодальне NLP розмиває межу між текстом та всім іншим. Сучасні системи обробляють текст, зображення, аудіо та відео разом — читають діаграму, прослуховують дзвінок та підсумовують обидва за один прохід.
NLP на пристрої / на периферії переносить компактні моделі на телефони та носимі пристрої, де логічний висновок відбувається локально. Вигодою є швидкість і конфіденційність: ваші дані ніколи не залишають пристрій.
Моделі малої мови програмування (SLM) є протилежністю тенденції «чим більше, тим краще»: ефективні, специфічні для задач моделі, які коштують лише частку вартості передових LLM та працюють швидше — часто є розумнішим вибором для чітко визначеного завдання.
Де НЛП заробляє собі на життя
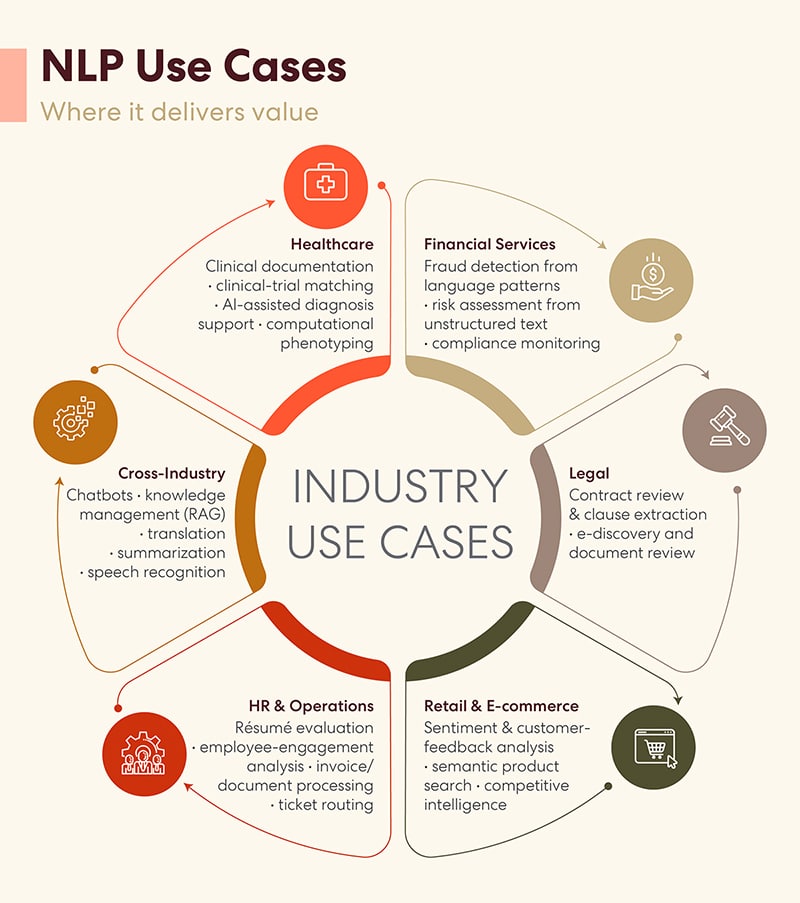
Варіанти використання більше не є спекулятивними — вони є пунктами бюджетів у різних галузях.
В охороні здоров'я НЛП складає клінічну документацію (що повертає лікарям години роботи щотижня), підбирає пацієнтів для клінічних випробувань та підтримує діагностику, аналізуючи нотатки, які жодна людина не могла б прочитати у великих масштабах. У фінансових послугах НЛП виявляє шахрайство за допомогою мовних шаблонів та контролює комунікації на предмет відповідності вимогам — робота, яка колись вимагала армій рецензентів. Юридичні команди використовують його для перевірки контрактів, вилучення пунктів та електронного розкриття інформації, стискаючи тижні перевірки документів до днів. Роздрібні торговці аналізують відгуки клієнтів на предмет настроїв та використовують семантичний пошук, який розуміє наміри, а не лише ключові слова. Команди відділу кадрів та операцій застосовують його для перевірки резюме, аналізу залученості, обробки рахунків-фактур та маршрутизації заявок.
І це охоплює кожну галузь: чат-боти, управління знаннями через RAG, переклад, реферування та розпізнавання мовлення. Спільна нитка завжди одна — текст, який раніше був непридатним для використання, стає даними, на які ви можете впливати.
Чесна картина: переваги та те, що все ще йде не так
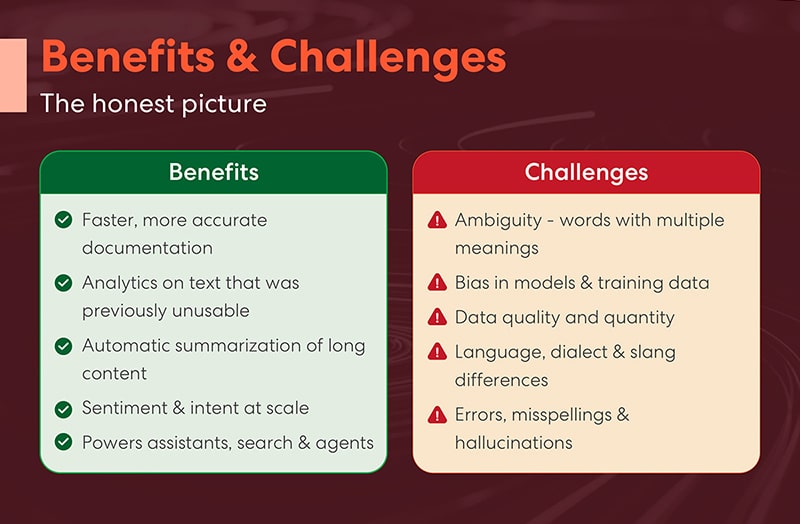
Винагорода від усього цього є конкретною. Документація пишеться швидше та точніше. Текст, який раніше був непридатним для використання, перетворюється на дані, які можна аналізувати. Довгий контент підсумовує сам себе. Настрої та наміри можна зчитувати в масштабах мільйонів взаємодій. І весь цей стек забезпечує роботу помічників, пошукових систем та агентів, на яких ваші команди вже покладаються.
Але було б нечесно завершувати тур на цьому, бо НЛП у 2026 році все ще має реальні проблеми.
Мова неоднозначна — слова мають кілька значень, а моделі все ще натикаються на контекст, який вловила б будь-яка людина. Моделі успадковують упередженість від своїх навчальних даних, що може непомітно спотворювати інструменти найму, рішення щодо кредитування та модерацію контенту. Якість даних залишається непримітним вузьким місцем: моделі настільки ж хороші, наскільки хороші те, з чого вони навчаються, а високоякісні, добре анотовані навчальні дані є рідкісними та дорогими. Діалекти, сленг та мови з низьким рівнем ресурсів мають гіршу продуктивність, ніж стандартна англійська. А галюцинації — впевнений, вільний, неправильний вивід — залишаються режимом невдачі, який змушує корпоративні розгортання бути обережними.
Жодна з цих причин не є причиною для того, щоб залишатися без уваги. Це причини для продуманого розгортання: базуйте моделі на перевірених даних, оцінюйте їх на вашій мові та для ваших користувачів, а також тримайте людей в курсі того, де помилки дорого коштують. Примітно, що більшість цих проблем мають ту саму першопричину — моделі даних навчаються та оцінюються на них — саме тому якість даних стала конкурентним диференціатором, а не просто пунктом призначення.
Що далі: п'ять трендів, на які варто звернути увагу у 2026 році
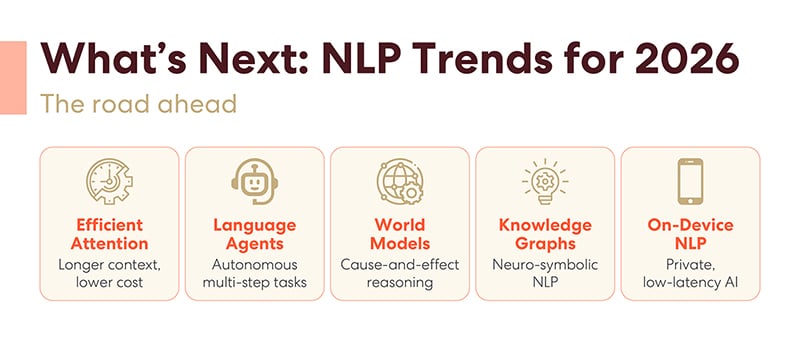
Забігаючи вперед, п'ять розробок визначатимуть наступний етап у цій галузі. Ефективні механізми уваги розширюють контекстні вікна, одночасно скорочуючи витрати, дозволяючи моделям одночасно обробляти цілі кодові бази або файли справ. Мовні агенти переходять від демонстрацій до робочого середовища, автономно керуючи багатоетапними робочими процесами. Світові моделі прагнуть надати ШІ справжнє причинно-наслідкове мислення, а не зіставлення зі зразками. Графи знань об'єднуються з нейронними підходами — нейросимволічним NLP — щоб зробити виходи моделей більш фактичними та перевіреними. А NLP на пристрої продовжує зменшувати кількість здатних моделей, доки приватний ШІ з низькою затримкою не поміститься у вашій кишені.
Закономірність для всіх п'яти: менше грубої сили, більше точності. Дешевше, швидше, більш обґрунтовано, ближче до користувача.
Bottom Line
НЛП у 2026 році вже не є новою технологією, а інфраструктурою, такою ж нічим не примітною та незамінною, як бази даних. Організації, що просуваються вперед, не запитують, чи використовувати НЛП; вони запитують, які завдання автоматизувати в першу чергу, як заземлити моделі на власних даних і як забезпечити, щоб навчальні дані, що лежать в основі всього цього, були варті того, щоб на них навчалися.






