

Прийняття рішень на основі даних є запорукою успіху та досконалості сучасного підприємства. Від фінтех і виробництва до роздрібної торгівлі та ланцюга постачання, кожна галузь їде на хвилі великих даних і приймає рішення на основі статистики за допомогою передових аналітичних моделей і алгоритмів. У сфері охорони здоров’я це стає ще більш корисним і рятівним для життя, слугуючи основою інновацій і наукових досягнень.
З таким величезним обсягом приходять також і виклики. Оскільки попит на медичні дані зростає для різних цілей, також зростає ймовірність витоків даних та нецільового використання конфіденційної інформації. Звіт за 2023 рік показує , що було викрадено понад 133 мільйони медичних записів та даних, що встановлює новий рекорд витоків даних в охороні здоров'я.
Прийняття нормативного акту HIPAA стало обнадійливим кроком в оптимізації конфіденційності даних у сфері охорони здоров'я , який одноосібно та значно зменшив кількість витоків даних на 48% . Звіти також показують, що 61% усіх витоків даних свідчать про недбалість працівників та фахівців у цій сфері.
Для подальшого стримування таких атак та масового розкриття вразливостей з'являються синтетичні дані пацієнтів . Як то кажуть, «сучасні проблеми вимагають сучасних рішень», поява синтетичних даних у сфері охорони здоров'я дозволяє медичним працівникам зміцнювати дані пацієнтів та використовувати моделі штучного інтелекту для допомоги у створенні нових даних.
У цій статті ми заглибимося в розуміння того, що таке генерація синтетичних даних та її безліч аспектів.
Синтетичні дані пацієнтів: що це?
Синтез — це процес створення чогось нового шляхом комбінування існуючих елементів. У цьому ж контексті синтетичні дані пацієнтів стосуються штучно створених даних із уже існуючих реальних даних пацієнтів.
У цьому процесі статистичні моделі та алгоритми вивчають масові обсяги даних пацієнтів, спостерігають шаблони та характеристики та генерують набори даних, які імітують реальні дані. Деякі з поширених методів, що застосовуються для створення штучних даних про пацієнтів, включають:
- Генеративні змагальні мережі (GNN)
- Статистичні моделі
- Методи анонімізації даних та інше
Синтетичні дані є чудовою та надійною технікою для усунення проблем конфіденційності, пов’язаних із ймовірністю розкриття інформації про пацієнта, яку можна повторно ідентифікувати. Щоб зрозуміти переваги таких даних, давайте розглянемо деякі з найбільш відомих випадків використання.
Випадки використання синтетичних даних
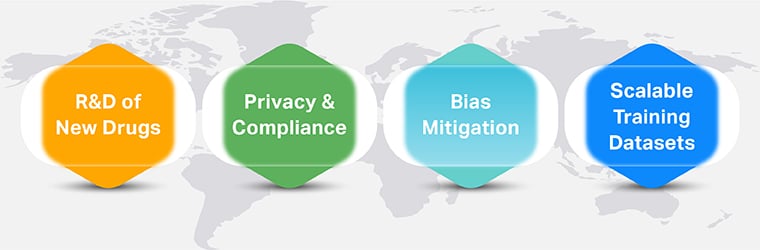
НДДКР нових ліків і ліків
Генерація даних клінічних випробувань є дискретною, і організації часто приховують критично важливу інформацію. Однак для цілей досліджень та розробок сумісність даних є ключовою для забезпечення проривів. Генерація синтетичних даних може допомогти дослідникам використовувати їх для приховування важливих фрагментів інформації, яку можна відстежувати, та ізольованих даних для спільного вивчення реакцій на ліки та їхніх побічних ефектів, рецептур, результатів кореляції тощо.
Конфіденційність і відповідність нормативним вимогам
Хоча ведуться розмови про необхідність централізованих хмарних систем EHR, існують також нормативні проблеми, пов’язані з проблемами конфіденційності та безпеки. Хоча сумісність даних неминуча, зацікавлені сторони в усьому спектрі охорони здоров’я повинні бути надзвичайно пильними щодо обміну даними пацієнтів. Синтетичні дані можуть допомогти приховати делікатні аспекти, зберігаючи ключові точки дотику та слугуючи ідеальними репрезентативними наборами даних.
Пом'якшення упередженості в охороні здоров'я
В охороні здоров’я впровадження упередженості є вродженим і неминучим. Наприклад, якщо в географічному місці спалахує епідемія, яка вражає чоловіків віком від 35 до 50 років, упередження вводиться за замовчуванням для цієї конкретної персони. Хоча жінки та діти все ще вразливі до цього спалаху, дослідникам потрібне об’єктивне підґрунтя для підтвердження своїх висновків. Синтетичні дані можуть допомогти усунути упередження та забезпечити збалансоване представлення.
Масштабовані навчальні набори даних із охорони здоров’я
Через такі нормативні акти, як GDPR, HIPAA тощо, доступність наборів даних для навчання розширених моделей машинного навчання для охорони здоров’я залишається обмеженою. Системи штучного інтелекту (ШІ) і моделі машинного навчання вимагають величезних обсягів даних для навчання, щоб стабільно ставати кращими в отриманні точних результатів.
Генерація синтетичних даних є благословенням у цій сфері, дозволяючи організаціям створювати штучні дані, адаптовані до їхніх вимог до обсягів, специфікацій та результатів, і одночасно заохочувати етичне використання синтетичних даних.
Недоліки та підводні камені синтетичних даних охорони здоров’я
Той факт, що існують системи та модулі для штучного генерування даних пацієнтів і медичних даних із наявних наборів даних, заспокоює. Однак ця методика не позбавлена певної частки недоліків. Давайте розберемося, що це таке.






