Ваша голосова модель чудово працює в демоверсії. Потім вона зустрічається з реальним користувачем — кимось із шотландським акцентом, хто замовляє хінглішем з машини, що рухається, — і стенограма розпадається.
Це неприємна правда голосового ШІ у 2026 році: моделі зазнають невдачі не тому, що архітектура неправильна. Вони зазнають невдачі тому, що набір даних ніколи не розмовляв мовами світу. Ваша голосова модель не масштабуватиметься, якщо ваші навчальні дані не масштабуватимуться — і це робить багатомовні дані мовлення одним із найважливіших стратегічних активів ШІ сьогодні.

Чому більшість моделей голосового штучного інтелекту не працюють у реальних умовах
П'ять проблем пояснюють переважну більшість збоїв голосового ШІ в реальних умовах, і, зокрема, приблизно 7 з 10 моделей мовлення не відповідають вимогам через прогалини в мовній різноманітності в їхніх навчальних даних.
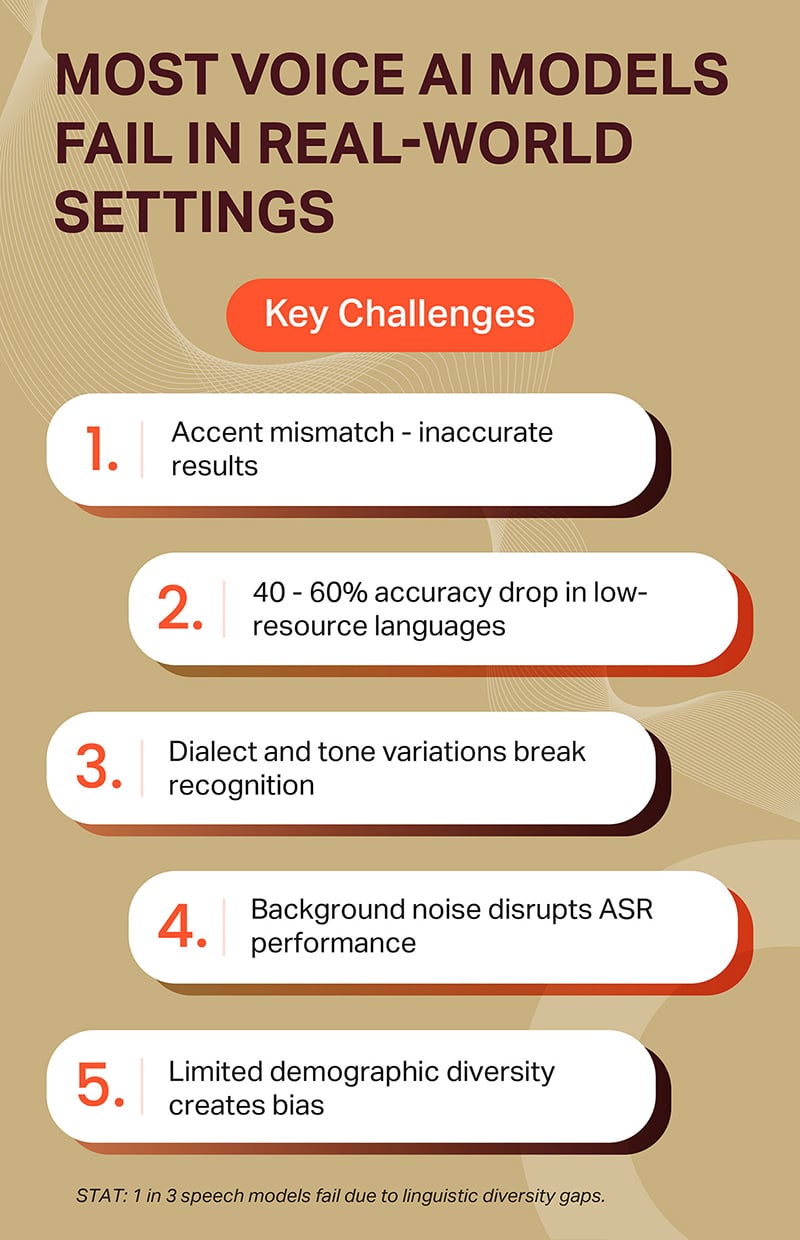
Невідповідність акцентів виникає на першому місці: модель, навчена переважно на американській англійській, видає неточні результати щойно чує ті самі слова з різними голосними.
Мови з низьким рівнем ресурсів страждають більше — падіння точності на 40–60% є типовим, коли модель зустрічається з мовою, яка мала недостатньо навчальних даних.
Діалектні та тональні варіації порушують розпізнавання навіть в межах однієї мови; «англійська» — це не одне й те саме, як і арабська, іспанська чи мандаринська.
Фоновий шум — транспорт, кухні, балачки в кол-центрі — порушує роботу ASR саме в тих середовищах, де голосові інтерфейси найбільш корисні.
А обмежена демографічна різноманітність у навчальних даних створює упередженість: моделі добре чують молодих міських носіїв мови, а старших чи сільських – погано.
Жодна з цих проблем не є проблемою моделі. Усі вони пов'язані з даними.
Штучний інтелект повинен розуміти реальних людей у реальних умовах
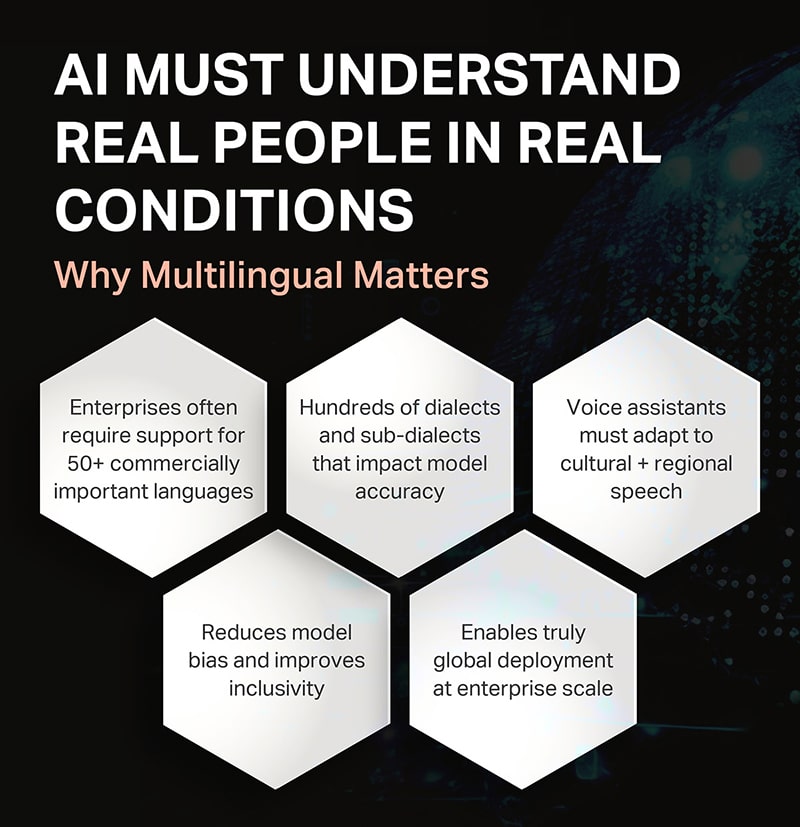
Чому багатомовні дані мають таке велике значення на рівні підприємства? Тому що масштаб проблеми більший, ніж припускає більшість команд.
Підприємствам регулярно потрібна підтримка понад 50 комерційно важливих мов , а під цими мовами існують сотні діалектів і піддіалектів , які безпосередньо впливають на точність моделі. Голосові помічники повинні адаптуватися до культурного та регіонального мовлення , а не лише до словникового запасу: темпу, форм ввічливості, перемикання кодів. Правильне виконання цього завдання зменшує упередженість моделі та покращує інклюзивність — користувачі, яких найчастіше підводить голосовий ШІ, є тими, хто вже недостатньо обслуговується. І зрештою, різноманітні дані мовлення — це те, що дозволяє справді глобальне розгортання в масштабі підприємства : один продукт, який працює однаково в Мумбаї, Мехіко та Манчестері.
Багатомовний набір даних мовлення DNA: який потужний набір даних охоплює
Тож як насправді виглядають дані мовлення світового класу? Шість вимірів — уявіть їх як ДНК набору даних.
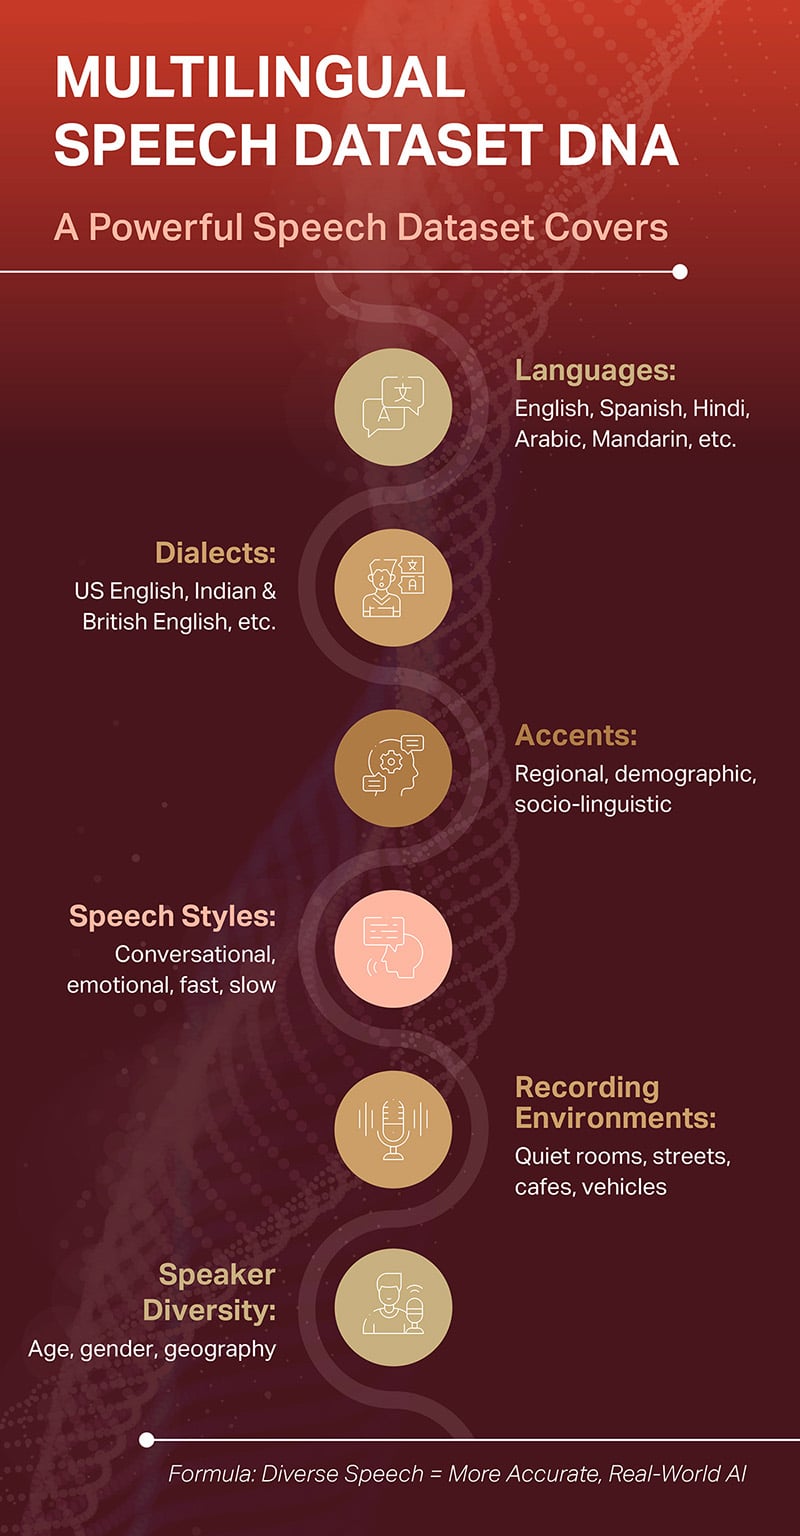
Мови: широке охоплення англійською, іспанською, хінді, арабською, китайською та іншими мовами.
Діалекти: різні варіанти, такі як американська, індійська та британська англійська, що розглядаються такими, якими вони є — різні мовленнєві моделі, а не одне відро.
Акценти: регіональні, демографічні та соціально-лінгвістичні варіації в межах кожного діалекту.
Стилі мовлення: розмовний, емоційний, швидкий, повільний — адже ніхто не розмовляє з голосовим асистентом так, як читає сценарій.
Умови запису: тихі кімнати, вулиці, кафе, транспортні засоби — акустичні умови реального життя.
Різноманітність спікерів: збалансоване висвітлення за віком, статтю та географічним розташуванням.
Формула проста: різноманітне мовлення = точніший, реальний штучний інтелект. Кожен пропущений вами вимір стає сегментом користувачів, який ваш продукт не вдається.
Де багатомовний мовленнєвий штучний інтелект допомагає: приклади використання в корпоративному середовищі
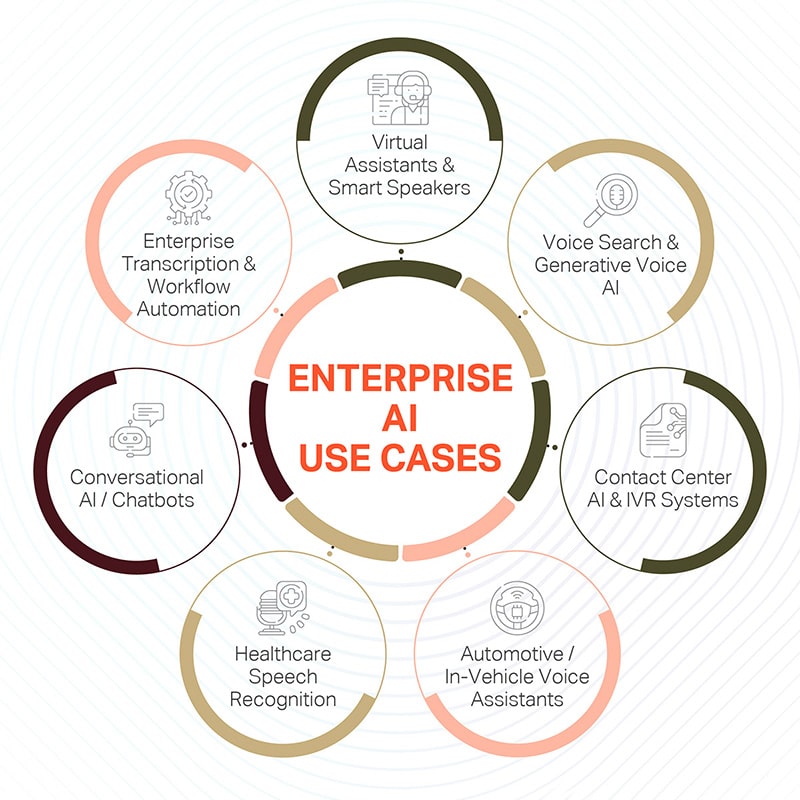
Застосування охоплюють майже всі точки дотику в галузі, де люди спілкуються з машинами: віртуальні помічники та розумні колонки; голосовий пошук; транскрипція та автоматизація робочих процесів у підприємстві; розмовний штучний інтелект та чат-боти; системи штучного інтелекту та IVR для контакт-центрів; розпізнавання мовлення в охороні здоров'я, де точність безпосередньо впливає на догляд; та голосові помічники в автомобілях, де шум та акценти стикаються в одному складному середовищі.
У кожному з них обмеженням користувацького досвіду є не модель, а те, скільки світової мови модель фактично почула.
Як Shaip забезпечує розвиток мовного штучного інтелекту світового класу
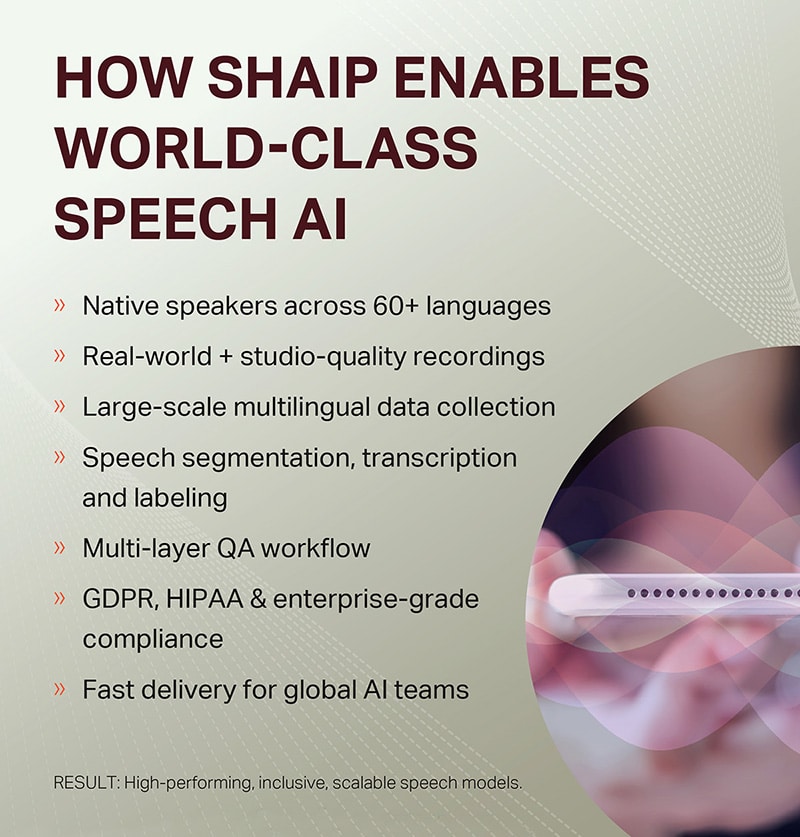
Подолання розривів у мовному різноманітті вимагає більше, ніж просто збору аудіо — це вимагає цілеспрямованих операцій з даними з контролем якості. Саме тут на допомогу приходить Shaip: носії мови понад 60 мовами; записи реальної та студійної якості; масштабний багатомовний збір даних; сегментація, транскрипція та маркування мовлення; багаторівневий робочий процес контролю якості; відповідність GDPR, HIPAA та корпоративному рівням; а також швидка доставка для глобальних команд штучного інтелекту.
Результатом є навчальні дані, які відображають людей, яким ваш продукт фактично служитиме, а не лише тих, кого найлегше зафіксувати.
Bottom Line
Голосовий ШІ перетнув поріг від новизни до інфраструктури, але його найбільші невдачі все ще пов'язані з однією першопричиною: наборами даних, які не звучать як справжній світ. Акценти, діалекти, шум та демографічне різноманіття — це не крайні випадки, а середовище розгортання.
Створіть голосовий штучний інтелект, який розуміє світ, і почніть там, де починаються невдачі: з даних.